> For the complete documentation index, see [llms.txt](https://navixy.com/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://navixy.com/docs/analytics/pt-br/dashboard-studio/writing-sql-queries.md).
# Escrevendo consultas SQL
Escreva consultas PostgreSQL otimizadas para visualizações do Dashboard Studio. Aprenda padrões de acesso aos dados, seleção de camada e boas práticas de desempenho
O Dashboard Studio usa SQL para recuperar dados dos esquemas do IoT Query. Você escreve SQL em dois contextos: editores de painel, nos quais as instruções alimentam visualizações, e o Editor SQL independente para exploração de dados. Esta página explica como escrever SQL eficaz para ambos os contextos, com ênfase nos requisitos de visualização, já que eles têm restrições estruturais específicas.
### Onde o SQL é usado
O Dashboard Studio oferece dois ambientes SQL para finalidades diferentes. Entender quando usar cada um ajuda você a trabalhar com mais eficiência.
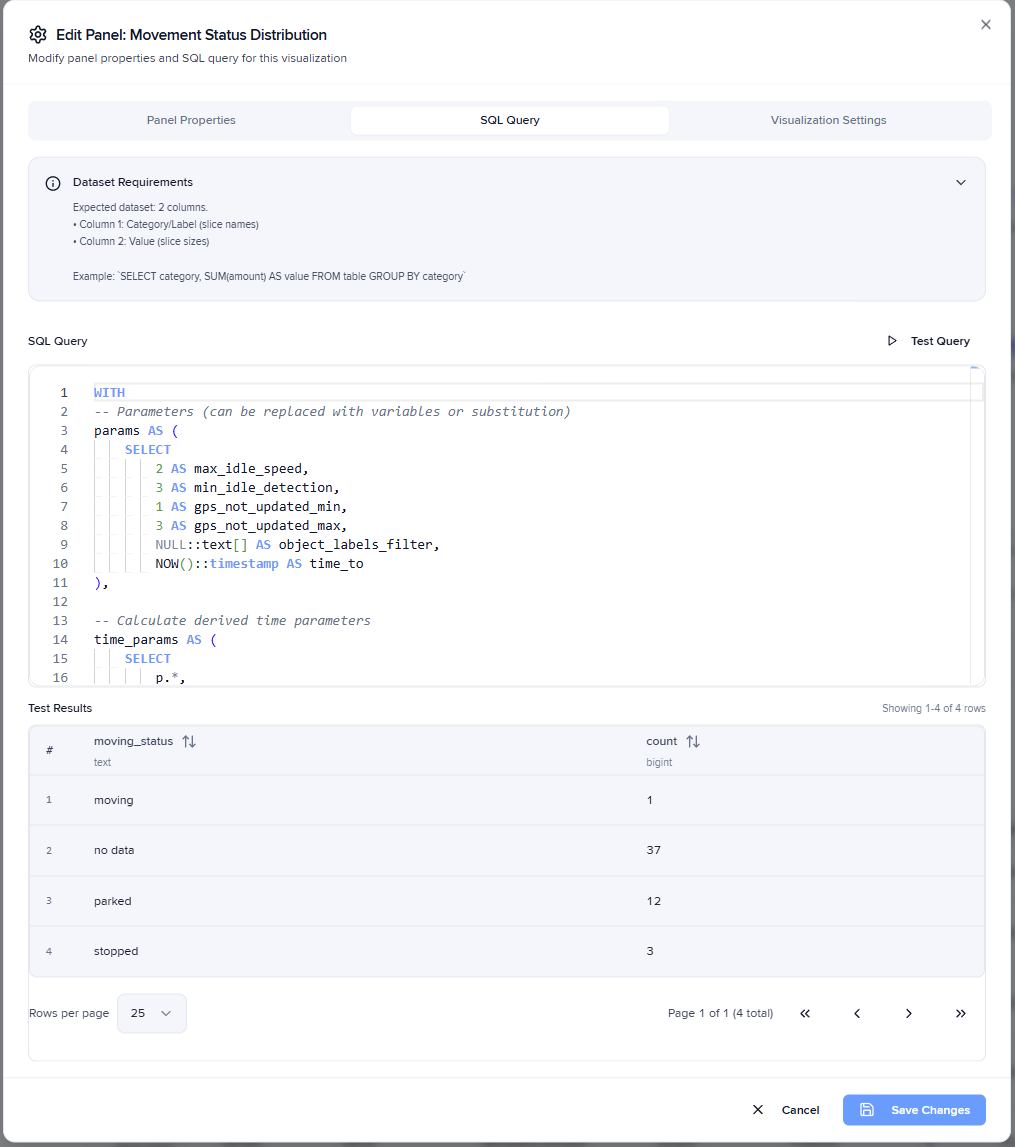
[**Consultas de visualização**](#how-to-write-sql-for-visualizations) alimentam painéis individuais em Relatórios. Você escreve essas instruções na **Consulta SQL** guia do editor de painel. Cada painel executa uma instrução que deve retornar dados em uma estrutura específica que corresponda ao tipo de visualização. Essas instruções são executadas quando os Relatórios são carregados ou atualizados, então o desempenho importa para a experiência do usuário. O SQL de visualização não pode modificar dados; todas as instruções são executadas como operações SELECT somente leitura nos esquemas do IoT Query.
**Relatórios** usa a mesma abordagem de SQL de visualização que os painéis do dashboard. Um Relatório executa uma consulta que alimenta três visualizações simultaneamente: a tabela de dados, o gráfico e o mapa de localização. A instrução deve retornar todas as colunas necessárias nos três componentes, então inclua as colunas de coordenadas, tempo e métricas juntas em um único SELECT.
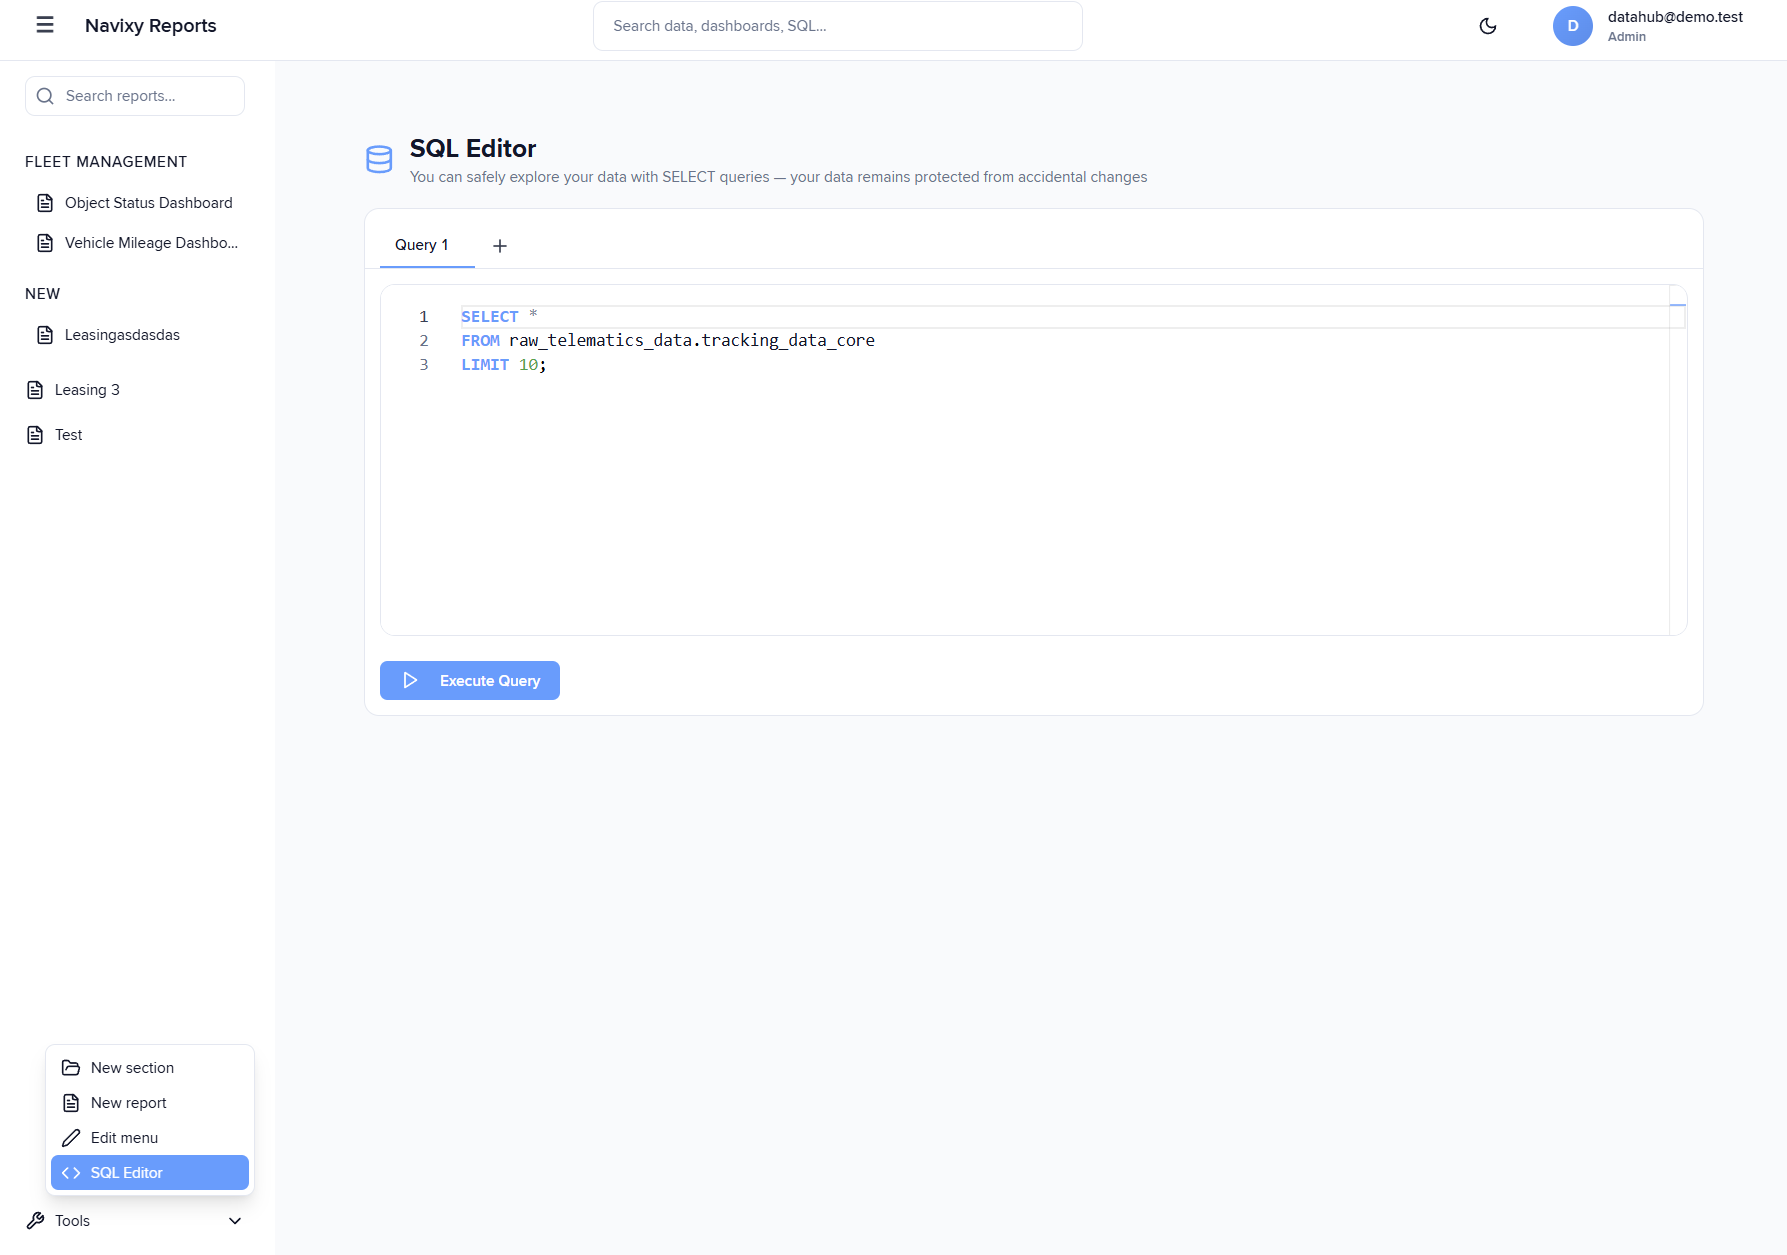
[**Editor SQL**](#how-to-use-the-sql-editor) oferece suporte à exploração e exportação de dados. Acesse o Editor SQL na barra lateral esquerda, em Tools. Escreva qualquer instrução SELECT para examinar a estrutura dos dados, validar suposições ou exportar resultados como CSV. O Editor SQL mostra tabelas de resultados completas com ordenação de colunas e fornece métricas de execução. Use isso para testar a lógica antes de adicionar SQL aos painéis de visualização, ou para extração ad hoc de dados que não precise de visualização.
{% hint style="info" %}
**A diferença principal**: o SQL de visualização deve corresponder exatamente às estruturas de colunas, enquanto as instruções no SQL Editor podem retornar qualquer formato de resultado. Teste a lógica complexa primeiro no SQL Editor e, depois, adapte-a para visualizações.
{% endhint %}
### Como escrever SQL para visualizações
O SQL de visualização deve retornar quantidades específicas de colunas e tipos de dados. O Dashboard Studio não pode renderizar um gráfico de barras a partir de três colunas ou um bloco de estatística a partir de dados de texto. Confira a seção Dataset Requirements na guia SQL Query para ver exatamente o que a visualização escolhida espera antes de escrever a instrução. A tabela abaixo contém os tipos de visualização compatíveis:
| Visualização | Requisito da consulta | Exemplo |
| ----------------------------------- | ------------------------------- | ----------------------------------------------------------------- |
| [Bloco de estatística](#stat-tiles) | Um único valor numérico | `SELECT COUNT(*) FROM schema.table` |
| [Gráfico de barras](#bar-charts) | Duas colunas: categoria, valor | `SELECT column1, COUNT(*) FROM schema.table GROUP BY column1` |
| [Gráfico de pizza](#pie-charts) | Duas colunas: rótulo, valor | `SELECT category, SUM(value) FROM schema.table GROUP BY category` |
| [Tabela](#tables) | Quaisquer colunas | `SELECT column1, column2, column3 FROM schema.table` |
| [Texto](#text-panels) | Nenhuma consulta necessária | Markdown, HTML ou texto simples |
| [Mapas](#maps) | Colunas de latitude e longitude | `SELECT latitude, longitude FROM schema.table` |
Blocos de estatísticas
Os blocos de estatística exibem valores numéricos únicos. As instruções devem retornar exatamente uma linha com uma coluna numérica:
{% code title="Total de viagens no mês atual" overflow="wrap" %}
```sql
SELECT COUNT(*) as value
FROM processed_common_data.Viagens
WHERE trip_start_time >= DATE_TRUNC('month', CURRENT_DATE);
```
{% endcode %}
{% code title="Distância total percorrida (km)" overflow="wrap" %}
```sql
SELECT ROUND(SUM(trip_distance_meters) / 1000.0, 1) as value
FROM processed_common_data.Viagens
ONDE trip_start_time >= CURRENT_DATE - INTERVAL '7 dias';
```
{% endcode %}
O nome da coluna não importa, apenas que o resultado seja um único valor numérico. O Dashboard Studio exibe esse valor com a formatação que você configura em Configurações de visualização.
Gráficos de barras
Gráficos de barras exigem exatamente duas colunas: categoria (texto ou data) e valor (numérico). A primeira coluna se torna o eixo X, a segunda se torna a altura das barras:
{% code title="Viagens por objeto" overflow="wrap" %}
```sql
COM Proprietário do dispositivo AS (
SELECT DISTINCT ON (o.device_id) o.device_id, o.object_label
FROM raw_business_data.objects o
WHERE o.is_deleted IS NOT TRUE
ORDER BY o.device_id, o.object_id
)
SELECT
d.object_label as category,
COUNT(*) as value
FROM processed_common_data.trips t
LEFT JOIN device_owner d ON d.device_id = t.device_id
WHERE t.trajeto_start_time >= DATE_TRUNC('month', CURRENT_DATE)
Grupo BY d.object_label
ORDER BY value DESC;
```
{% endcode %}
Grupo por uma coluna de texto. `raw_business_data.vehicles.vehicle_type` armazena um código inteiro em vez de um nome, então agrupá-lo rotula as barras `1`, `2`, `3`.
O `device_owner` o bloco no topo não é opcional sempre que você vincula rótulos de objeto a viagens ou eventos. Veja [Como unir rótulos de Objeto](#how-to-join-object-labels).
{% code title="Contagens diárias de trajetos" overflow="wrap" %}
```sql
SELECT
DATE_TRUNC('day', trip_start_time)::date as category,
COUNT(*) as value
FROM processed_common_data.Viagens
WHERE trip_start_time >= CURRENT_DATE - INTERVAL '30 days'
AGRUPAR POR DATE_TRUNC('day', Trajeto_start_time)
ORDER BY category;
```
{% endcode %}
Use `ORDER BY` para controlar a sequência de barras. Classifique por valor para comparações ranqueadas ou por categoria para progressões de séries temporais.
Gráficos de pizza
Gráficos de pizza exigem exatamente duas colunas: rótulo (texto) e valor (numérico). A primeira coluna se torna os rótulos das fatias, a segunda determina os tamanhos das fatias:
{% code title="Viagens por zona de partida" %}
```sql
SELECT
start_zone como rótulo,
COUNT(*) as value
FROM processed_common_data.Viagens
WHERE trip_start_time >= DATE_TRUNC('month', CURRENT_DATE)
AND start_zone IS NOT NULL
AGRUPAR POR start_zone
ORDER BY value DESC
LIMIT 10;
```
{% endcode %}
Adicione cláusulas LIMIT para categorias com muitos valores. Gráficos de pizza com 20+ fatias ficam ilegíveis; limite-se às 10-15 principais categorias.
Tabelas
As tabelas aceitam qualquer número de colunas com qualquer tipo de dados. Selecione as colunas que você quer exibir:
{% code title="Detalhes do trajeto recente" %}
```sql
SELECT
device_id,
Trajeto_start_time,
Trajeto_end_time,
ROUND(Trajeto_distance_meters / 1000.0, 1) as distance_km,
ROUND( Trajeto_duration_seconds / 60.0) as duration_minutes,
max_speed
FROM processed_common_data.Viagens
WHERE trip_start_time >= CURRENT_DATE - INTERVAL '7 days'
ORDER BY trip_start_time DESC
LIMIT 100;
```
{% endcode %}
Os nomes das colunas se tornam cabeçalhos da tabela. Use aliases com espaços para cabeçalhos legíveis: `ROUND(trip_distance_meters / 1000.0, 1) as "Distance (km)"`.
Painéis de texto
Painéis de texto exibem conteúdo em Markdown, HTML ou texto simples. Eles não executam uma consulta SQL.
Na **Conteúdo** aba, selecione uma opção em **Modo de conteúdo**:
* **Markdown** (padrão) oferece suporte a formatação, como títulos e links.
* **HTML** renderiza a marcação bruta.
* **Texto simples** exibe o conteúdo exatamente como você o inseriu e não interpreta nenhuma marcação.
Use painéis de texto para títulos de seção, instruções ou contexto junto às suas visualizações de dados.
Mapas
Os painéis de mapa desenham um marcador por linha. As consultas devem retornar uma coluna de latitude e uma coluna de longitude:
{% code title="Últimas posições dos veículos" overflow="wrap" %}
```sql
COM Proprietário do dispositivo AS (
SELECT DISTINCT ON (o.device_id) o.device_id, o.object_label
FROM raw_business_data.objects o
WHERE o.is_deleted IS NOT TRUE
ORDER BY o.device_id, o.object_id
)
SELECT DISTINCT ON (t.device_id)
d.object_label,
t.latitude / 1e7 AS latitude,
t.longitude / 1e7 AS longitude
FROM raw_telematics_data.tracking_data_core t
LEFT JOIN device_owner d ON d.device_id = t.device_id
WHERE t.device_time >= NOW() - INTERVAL '24 hours'
AND t.latitude <> 0 AND t.longitude <> 0
ORDER BY t.device_id, t.device_time DESC;
```
{% endcode %}
`DISTINCT ON` com o correspondente `ORDER BY` mantém uma linha por dispositivo, a mais recente. Sem isso, a consulta plota todos os pontos históricos que o dispositivo já enviou.
Dashboard Studio detecta colunas de coordenadas automaticamente quando elas usam nomes comuns, como `latitude`, `lat`, ou `gps_lat` para latitude e `longitude`, `lon`, ou `lng` para longitude. Se suas colunas usarem nomes diferentes, selecione-as manualmente em Visualization Settings.
As coordenadas devem estar em graus decimais. Quando uma tabela as armazena como inteiros escalados, divida por `1e7` como mostrado acima. Quaisquer outras colunas que a instrução retorne aparecem no popup do marcador.
As consultas de relatórios seguem as mesmas regras estruturais que as consultas de visualização em painéis. Como uma única instrução alimenta a tabela de dados, o gráfico e o mapa de localização ao mesmo tempo, talvez você precise combinar colunas que seriam escritas como consultas separadas de painel em um painel. Por exemplo, uma consulta de painel de gráfico de barras que retorna duas colunas não é suficiente para um relatório que também precisa de coordenadas GPS para o mapa de localização. Inclua todas as colunas necessárias para cada componente em uma única instrução. A lógica principal de filtragem e JOIN permanece a mesma que nas consultas de painel; apenas a cláusula SELECT precisa ser mais ampla.
### Como escrever SQL para relatórios
Um relatório executa uma consulta SQL que alimenta três componentes simultaneamente: a tabela de dados, o gráfico e o mapa de localização. Diferentemente dos painéis do dashboard, em que cada painel tem sua própria consulta focada, uma consulta de relatório deve retornar todas as colunas necessárias em todos os componentes em uma única instrução SELECT.
#### Requisitos de colunas por componente
Cada componente do relatório tem requisitos específicos de colunas. Sua consulta deve atender a todos os componentes que você habilitou.
| Componente | Colunas obrigatórias | Notas |
| ------------------- | --------------------------------------------------------------------------- | ----------------------------------------------------------------- |
| Tabela de dados | Quaisquer colunas | Todas as colunas retornadas aparecem como colunas da tabela |
| Gráfico | Pelo menos uma coluna de tempo ou categoria, pelo menos uma coluna numérica | As colunas de eixo são selecionadas nas configurações do gráfico |
| Mapa de localização | Latitude e longitude em graus decimais | O Dashboard Studio detecta automaticamente colunas de coordenadas |
Como a tabela de dados aceita quaisquer colunas, ela não impõe restrições adicionais. O gráfico e o mapa de localização orientam a maioria das decisões estruturais.
#### Combinando componentes em uma consulta
Uma consulta que retorna apenas as colunas necessárias para um gráfico (duas colunas: categoria e valor) não pode também alimentar um mapa de localização. Você deve incluir todas as colunas necessárias juntas.
O exemplo a seguir retorna colunas para todos os três componentes: uma coluna de tempo e uma coluna numérica para o gráfico, colunas de coordenadas para o mapa de localização e atributos adicionais que aparecem na tabela de dados.
```sql
COM Proprietário do dispositivo AS (
SELECT DISTINCT ON (o.device_id) o.device_id, o.object_label
FROM raw_business_data.objects o
WHERE o.is_deleted IS NOT TRUE
ORDER BY o.device_id, o.object_id
)
SELECT
t.device_id,
d.object_label,
t.device_time,
t.latitude::float / 10000000 AS latitude,
t.longitude::float / 10000000 AS longitude,
t.speed::float / 100 AS speed
FROM raw_telematics_data.tracking_data_core t
LEFT JOIN device_owner d ON d.device_id = t.device_id
WHERE t.device_time >= NOW() - INTERVAL '24 hours'
ORDER BY t.device_time DESC
LIMIT 1000
```
Nesta consulta, `device_time` e `velocidade` atenda ao gráfico, `latitude` e `longitude` atenda ao mapa de localização, e todas as colunas apareçam na tabela de dados.
{% hint style="info" %}
As tabelas brutas de telemetria armazenam coordenadas e velocidade como inteiros escalonados. As coordenadas são divididas por 10,000,000 (10⁷) para converter em graus decimais, e a velocidade é dividida por 100 (10²) para converter em km/h. Aplique essas conversões em qualquer consulta que leia de `raw_telematics_data` tabelas.
{% endhint %}
#### Adaptando consultas de painéis do dashboard para Relatórios
Qualquer consulta de painel de um dashboard é um ponto de partida válido para um relatório. O ajuste necessário depende de quais componentes você quer habilitar.
Se a consulta do painel já for uma visualização de tabela que retorna várias colunas, ela pode já incluir tudo o que é necessário. Adicione colunas de coordenadas se o mapa de localização for necessário.
Se a consulta do painel for um gráfico de barras ou uma consulta de bloco de estatística que retorna resultados agregados, provavelmente faltará o detalhe em nível de linha necessário para a tabela de dados e o mapa de localização. Nesse caso, remova a agregação e trabalhe diretamente com as tabelas subjacentes da camada de dados brutos ou da camada de transformação.
[Livro de receitas de SQL](/docs/analytics/pt-br/example-queries.md) contém exemplos de consulta prontos para uso para análises comuns da Frota. As receitas do livro podem ser adaptadas para Relatórios adicionando colunas de coordenadas onde o mapa de localização for necessário. A lógica central de WHERE e JOIN é transferida diretamente; ajuste apenas a cláusula SELECT para cobrir todos os componentes necessários.
### Como usar variáveis globais
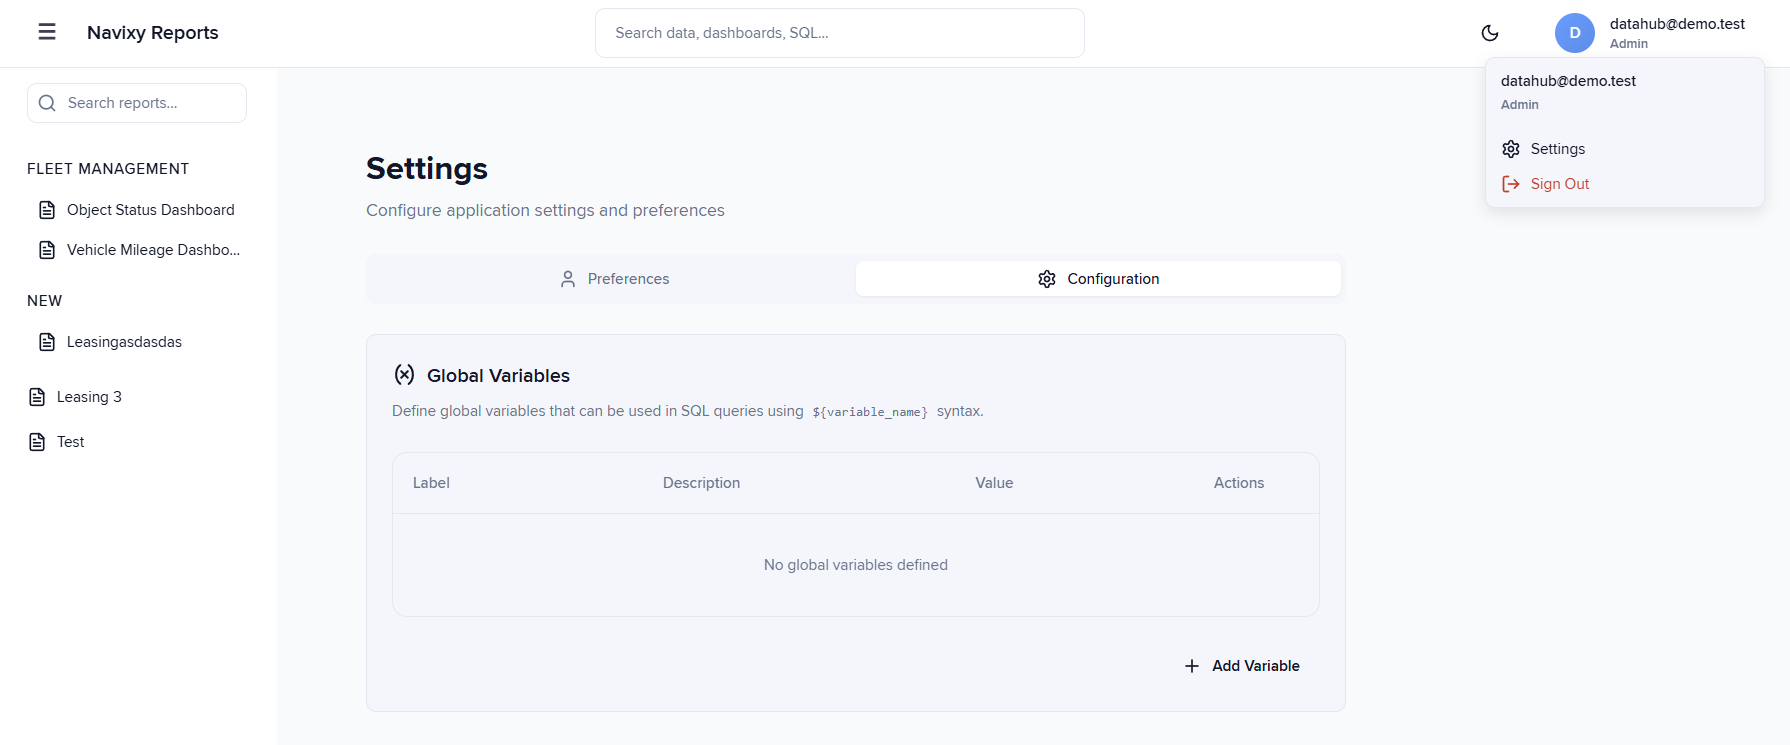
As variáveis globais fornecem valores reutilizáveis em várias instruções SQL. Defina variáveis em **Configurações > Configuração > Variáveis globais**, então faça referência a eles usando `${variable_name}` sintaxe.
Defina variáveis para valores que mudam periodicamente, mas permanecem consistentes em vários painéis: intervalos de datas de análise, filtros de tipo de veículo ou valores de limite. Quando esses valores mudarem, atualize a definição da variável uma vez, em vez de editar instruções SQL individuais.
{% code title="Usando variáveis de intervalo de datas" %}
```sql
SELECT
DATE_TRUNC('day', trip_start_time)::date as category,
COUNT(*) as value
FROM processed_common_data.Viagens
WHERE trip_start_time >= '${analysis_start_date}'::date
E o Trajeto trip_start_time < '${analysis_end_date}'::date
AGRUPAR POR DATE_TRUNC('day', Trajeto_start_time)
ORDER BY category;
```
{% endcode %}
Variáveis armazenam valores de texto. Faça cast delas para tipos apropriados em SQL: `'${variable_name}'::date` para datas, `'${variable_name}'::integer` para números.
Para parâmetros específicos da instrução que mudam com frequência, você pode usar blocos de parâmetros CTE no início:
```sql
WITH params AS (
SELECT
300 como min_idle_seconds,
10 como max_idle_speed_kmh,
'${analysis_start_date}'::date as date_from,
'${analysis_end_date}'::date as date_to
)
SELECT
e.device_id,
COUNT(*) as idle_count,
ROUND(SUM(e.duration_sec) / 60.0) as total_idle_minutes
FROM processed_common_data.rule_based_driver_events e
CROSS JOIN params p
WHERE e.event_type = 'idling_soft'
AND e.device_time >= p.date_from
AND e.device_time < p.date_to
AND e.speed_kmh <= p.max_idle_speed_kmh
AND e.duration_sec >= p.min_idle_seconds
GRUPO POR e.device_id
ORDER BY total_idle_minutes DESC;
```
Este padrão combina variáveis globais (intervalos de data) com parâmetros específicos da instrução (limiares), mantendo todos os valores ajustáveis no topo para facilitar a Manutenção.
### Como unir rótulos de Objeto
`raw_business_data.objects.device_id` Não é único. Um dispositivo pode carregar vários registros de Objeto, porque um dispositivo reatribuído entre objetos deixa as linhas anteriores para trás. Tabelas fato como `processed_common_data.Viagens` ignição ligada `device_id` sozinho, então uma junção simples para `objetos` multiplica cada linha de fato pelo número de registros de Objeto correspondentes. As contagens e somas então ficam altas demais, sem nenhum erro para avisá-lo.
Filtrando por `is_deleted` não é suficiente por si só, porque mais de um registro pode passar por esse filtro. Primeiro, selecione uma linha por dispositivo e, em seguida, faça o join disso:
{% code title="A junção entre Objeto e rótulo" %}
```sql
COM Proprietário do dispositivo AS (
SELECT DISTINCT ON (o.device_id) o.device_id, o.object_id, o.object_label
FROM raw_business_data.objects o
WHERE o.is_deleted IS NOT TRUE
ORDER BY o.device_id, o.object_id
)
SELECT d.object_label, COUNT(*) AS trips
FROM processed_common_data.trips t
LEFT JOIN device_owner d ON d.device_id = t.device_id
WHERE t.trip_start_time >= CURRENT_DATE - INTERVAL '30 days'
GROUP BY d.object_label;
```
{% endcode %}
Use `LEFT JOIN` em vez de uma junção interna, para que um dispositivo sem nenhum registro de Objeto restante ainda apareça, em vez de ser removido do resultado.
`processed_common_data.rule_based_driver_events` é a exceção. Já carrega `Objeto_id` e `rótulo_do_objeto`, e suas coordenadas estão em graus, então ele não precisa nem desta junção nem da `/1e7` conversão.
### Como acessar os esquemas do IoT Query
O IoT Query organiza os dados em camadas de dados brutos, transformação e insight. As camadas de dados brutos e transformação contêm dois esquemas PostgreSQL cada, e você referencia uma tabela pelo nome do esquema, e não pela camada. Escolher a camada certa economiza tempo e mantém o SQL claro. Para detalhes completos do esquema, consulte o [Visão geral do esquema IoT Query](/docs/analytics/pt-br/iot-query/schema-overview.md).
**Camada de dados brutos** contém o que os dispositivos e a plataforma Navixy registraram, em dois esquemas. `raw_telematics_data` contém dados de Monitor, entrada e estado: `raw_telematics_data.rastreamento_data_core` armazena todas as posições de GPS com carimbos de data e hora, coordenadas e leituras de sensores. `raw_business_data` contém entidades de negócio como `raw_business_data.objects`, `raw_business_data.Veículos`, e `raw_business_data.zones`. Use a camada de dados brutos para análise no nível de ponto, para valores brutos de sensores e para os rótulos e atributos que você associa aos dados processados.
**Camada de transformação** mantém entidades processadas em dois esquemas. `processed_common_data` contém as transformações que a Navixy mantém, que estão disponíveis sem configuração: `Viagens`, `sensors_data_by_hours`, `eventos de motorista baseado em regras`, e `input_change_events`. `processed_custom_data` contém as transformações que você cria por conta própria no Transformation Builder. Use a camada Transformation para a maioria das necessidades de visualização, porque ela fornece estruturas prontas para análise. Veja [Transformações comuns](/docs/analytics/pt-br/iot-query/schema-overview/transformation-layer/common-transformations.md) para as colunas de cada tabela.
**Camada de insights** oferece métricas pré-agregadas e modelos dimensionais para análises complexas. Use-o para estatísticas de Frota ou análise multidimensional que, de outra forma, exigiriam junções complexas com tabelas da camada de Transformação.
{% hint style="warning" %}
Os nomes das camadas Bronze, Silver e Gold descrevem a arquitetura medallion que as camadas seguem. Elas não são nomes de schema, e `silver.Viagens` não é uma tabela que você pode consultar. Use os nomes de esquema acima.
{% endhint %}
Tabelas de referência usando `schema.table` formato: `processed_common_data.Viagens`, não apenas `Viagens`. Inclua filtros de intervalo de datas nas cláusulas WHERE para limitar os dados analisados:
{% code title="Filtre sempre por intervalos de tempo" %}
```sql
SELECT device_id, COUNT(*) as trip_count
FROM processed_common_data.Viagens
WHERE trip_start_time >= CURRENT_DATE - INTERVAL '30 days'
Grupo BY device_id;
```
{% endcode %}
A maioria das instruções SQL filtra por dispositivo, intervalo de tempo ou ambos. Adicione esses filtros cedo nas cláusulas WHERE para reduzir o volume de dados processados.
### Unidades de medida nos resultados da consulta
O IoT Query armazena cada medição em uma unidade fixa, e o Dashboard Studio renderiza o que a consulta retorna. Ele não converte os valores para o sistema de medição definido na conta Navixy, como faz o app Dashboards pronto para uso. Duas pessoas com Configurações de conta diferentes veem os mesmos números no mesmo painel.
A unidade de cada coluna está documentada em [Visão geral do esquema IoT Query](/docs/analytics/pt-br/iot-query/schema-overview.md), e muitas colunas o nomeiam diretamente. `Trajeto_distancia_metros` contém medidores, `avg_speed` e `max_speed` mantenha km/h, e `altitude_start` e `altitude_end` mantenha metros acima do nível do mar. Verifique a coluna antes de rotular um painel.
Converta na consulta quando seus leitores trabalharem com outras unidades e nomeie a unidade no alias da coluna para que o painel se rotule corretamente:
{% code title="Retornando a distância em milhas em vez de metros" %}
```sql
SELECT device_id,
ROUND(SUM(trip_distance_meters) / 1609.344, 1) as "Distance (mi)"
FROM processed_common_data.Viagens
WHERE trip_start_time >= CURRENT_DATE - INTERVAL '7 days'
Grupo BY device_id;
```
{% endcode %}
Divida metros por 1,609.344 para milhas, km/h por 1.609344 para mph e metros por 0.3048 para pés.
### Como usar o Editor SQL
Acesse o SQL Editor na barra lateral esquerda, em Tools. Use-o para três finalidades principais: testar a lógica antes de adicioná-la aos painéis, explorar os esquemas de dados para entender as colunas disponíveis e exportar dados que não precisam de visualização.
O Editor SQL oferece suporte a várias abas para diferentes instruções. Escreva SQL nas abas, execute com o botão "Execute Query" e veja os resultados na tabela abaixo. Os resultados exibem métricas de execução (tempo de execução, linhas retornadas) e oferecem suporte à ordenação de colunas para uma análise rápida dos dados.
Exporte os resultados como CSV usando o botão "Export CSV". Isso funciona para relatórios ad hoc ou extrações de dados para análise externa. O SQL Editor não tem limite de linhas de resultado, ao contrário do SQL de visualização, que deve retornar conjuntos de dados focados.
Teste o SQL de visualização no SQL Editor antes de adicioná-lo aos painéis. Escreva a instrução, verifique se ela retorna as colunas e os tipos de dados esperados e, em seguida, copie-a para a guia SQL Query do editor de painel. Esse fluxo de trabalho detecta problemas estruturais antes de você configurar as definições de visualização.
Padrão de exploração para novos dados:
{% code expandable="true" %}
```sql
-- 1. Examinar a estrutura da tabela
SELECT * FROM processed_common_data.trips LIMIT 10;
-- 2. Verifique a cobertura do intervalo de datas
SELECT
MIN(trip_start_time) as earliest,
MAX(trajeto_start_time) como mais recente,
COUNT(*) as total_trips
A PARTIR de processed_common_data.trips;
-- 3. Teste da lógica de filtragem
SELECT
device_id,
Trajeto_start_time,
Trajeto_distancia_metros
FROM processed_common_data.Viagens
WHERE trip_start_time >= '2024-01-01'
AND device_id = 12345
ORDER BY Trajeto_start_time;
-- 4. Adaptar para visualização (2 colunas para gráfico de barras)
SELECT
DATE_TRUNC('day', trip_start_time)::date as day,
COUNT(*) as viagens
FROM processed_common_data.Viagens
WHERE trip_start_time >= '2024-01-01'
AND device_id = 12345
AGRUPAR POR DATE_TRUNC('day', Trajeto_start_time)
ORDER BY day;
```
{% endcode %}
### Padrões comuns de SQL
A maior parte do SQL de visualização segue padrões semelhantes. Copie essas estruturas e ajuste filtros, colunas e agregações para suas necessidades específicas.
Contagens de séries temporais para Monitor de tendências
```sql
SELECT
DATE_TRUNC('hour', trip_start_time) as time_bucket,
COUNT(*) as event_count
FROM processed_common_data.Viagens
WHERE trip_start_time >= CURRENT_DATE - INTERVAL '24 hours'
GROUP BY DATE_TRUNC('hour', trip_start_time)
ORDER BY time_bucket;
```
Classificações por categoria para comparar grupos
```sql
SELECT
category_column,
COUNT(*) as count
FROM schema.table
WHERE filter_conditions
GROUP BY category_column
ORDER BY count DESC
LIMIT 15;
```
Cálculos de métricas para estatísticas agregadas
```sql
SELECT
ROUND(SUM(trip_distance_meters) / 1000.0, 1) as total_distance_km,
ROUND(AVG(trip_duration_seconds) / 60.0) as avg_duration_minutes,
COUNT(*) as contagem_de_trajetos
FROM processed_common_data.Viagens
WHERE trip_start_time >= DATE_TRUNC('week', CURRENT_DATE);
```
Resumos filtrados com múltiplas condições
```sql
SELECT
device_id,
COUNT(*) as Viagens,
ROUND(SUM(trip_distance_meters) / 1000.0, 1) as total_km
FROM processed_common_data.Viagens
WHERE trip_start_time >= '${period_start}'::date
E Trajeto_start_time < '${period_end}'::date
E Trajeto_distance_meters >= 5000
AND trip_duration_seconds >= 600
GROUP BY device_id
HAVING COUNT(*) >= 5
ORDER BY total_km DESC;
```
### O que fazer quando SQL falha
Falhas de execução se enquadram em três categorias: incompatibilidades estruturais com os requisitos de visualização, erros de sintaxe SQL ou filtros que não retornam dados.
#### **Incompatibilidades na estrutura das colunas**
Ocorre quando os resultados não correspondem às expectativas de visualização. Se você selecionou um gráfico de barras, mas seu SQL retorna três colunas, o Dashboard Studio não consegue renderizá-lo. Verifique os Requisitos do conjunto de dados na guia Consulta SQL. O gráfico de barras precisa de exatamente duas colunas (categoria, valor), então ajuste sua cláusula SELECT:
```sql
-- Incorreto: três colunas
SELECT device_id, trip_start_time, COUNT(*) FROM processed_common_data.trips GROUP BY device_id, trip_start_time;
-- Correto: duas colunas
SELECT device_id, COUNT(*) as trips FROM processed_common_data.trips GROUP BY device_id;
```
#### **Erros de sintaxe SQL**
Mostre Mensagens de erro específicas. Problemas comuns incluem prefixos de schema ausentes (`Viagens` em vez de `processed_common_data.Viagens`), erros de digitação nos nomes das colunas ou conversão incorreta de data. Teste as instruções no Editor SQL para ver mensagens de erro detalhadas com números de linha.
#### **Resultados vazios**
Apesar da execução bem-sucedida, isso indica que os filtros excluem todos os dados. Teste o SQL sem cláusulas WHERE no SQL Editor para verificar se a tabela contém dados e, em seguida, adicione filtros incrementalmente para identificar qual condição exclui os resultados esperados.
#### Problemas de desempenho
Se as instruções executarem lentamente ou atingirem timeout, adicione filtros de intervalo de datas às cláusulas WHERE. Operações que varrem tabelas inteiras processam milhões de linhas desnecessariamente:
```sql
-- Lento: sem filtro de data
SELECT device_id, COUNT(*) FROM processed_common_data.trips GROUP BY device_id;
-- Rápido: filtro de intervalo de datas
SELECT device_id, COUNT(*)
FROM processed_common_data.Viagens
WHERE trip_start_time >= CURRENT_DATE - INTERVAL '30 days'
Grupo BY device_id;
```
Para orientações adicionais sobre desempenho, consulte [Como acessar os esquemas do IoT Query](#how-to-access-iot-query-schemas) para obter as melhores práticas sobre filtragem e seleção de schema.
### Onde encontrar exemplos de SQL
O [Livro de receitas de SQL](/docs/analytics/pt-br/example-queries.md) fornece exemplos completos para análises telemáticas comuns. Estas receitas demonstram padrões para análise de Trajeto, cálculos de visita a zonas, detecção de marcha lenta e métricas da Frota. Cada receita inclui a instrução SQL completa, a explicação da lógica e os resultados de exemplo.
Adapte os exemplos do Recipe Book para visualizações ajustando a cláusula SELECT para atender aos requisitos da visualização. Uma receita que retorna registros detalhados de Trajeto pode virar um gráfico de barras ao adicionar GROUP BY e uma agregação COUNT. Uma instrução que calcula métricas para Veículos pode virar um stat tile ao adicionar SUM para todos os Veículos.
Você só precisa:
1. Copiar exemplos de [Livro de receitas](/docs/analytics/pt-br/example-queries.md) para o Editor do Dashboard Studio.
2. Teste com seus dados reais.
3. Verifique os resultados e, em seguida, modifique a cláusula SELECT para a visualização de destino.
A lógica principal de WHERE e JOIN permanece a mesma; você ajusta apenas a estrutura de saída.
Para detalhes do schema, consulte o [Visão geral do esquema IoT Query](/docs/analytics/pt-br/iot-query/schema-overview.md). Esta referência explica as tabelas disponíveis, as definições de colunas e os relacionamentos entre as Camadas Raw data, Transformation e Insight.
---
# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.
## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation dynamically by asking a question.
Perform an HTTP GET request on the current page URL with the `ask` query parameter, and the optional `goal` query parameter:
```
GET https://navixy.com/docs/analytics/pt-br/dashboard-studio/writing-sql-queries.md?ask=&goal=
```
`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is optional and describes the broader end goal you are ultimately trying to accomplish on behalf of the user. GitBook uses it to tailor the answer towards what is most useful for that goal.
The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.
Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.