> For the complete documentation index, see [llms.txt](https://navixy.com/docs/llms.txt). Markdown versions of documentation pages are available by appending `.md` to page URLs; this page is available as [Markdown](https://navixy.com/docs/analytics/ru/iot-query/schema-overview/transformation-layer/common-transformations/sensor-data-aggregation.md).

# Агрегация данных датчиков

Обрабатывайте сырые показания датчиков IoT в почасовые записи с временными интервалами с декодированной калибровкой, расчетами объема топлива и агрегацией на уровне устройств

Трансформация агрегации данных датчиков пересэмплирует необработанные показания датчиков в сводные записи с временной разбивкой. Каждая строка в `processed_common_data.sensors_data_by_hours` представляет один датчик на одном устройстве для одного интервала: среднее, минимальное и максимальное декодированное значение и, для датчиков уровня топлива, откалиброванный объем в каждой из этих точек.

Встроенная трансформация запускается каждый час и агрегирует последний час необработанных данных датчиков из `raw_telematics_data.inputs` в часовые интервалы. Каждый запуск добавляет в таблицу свежий набор почасовых записей.

{% hint style="info" %}
Данные в этой таблице могут быть не старше 1 часа, отражая последний завершенный запуск.\
Все временные метки хранятся в UTC.\
В агрегации участвуют только числовые значения датчиков. Текстовые состояния, отрицательные числа и запись в научной нотации отфильтровываются на источнике.
{% endhint %}

### Выходная таблица: processed\_common\_data.sensors\_data\_by\_hours

Каждая строка представляет один интервал агрегированных показаний одного датчика на одном устройстве. Во встроенной трансформации каждый интервал охватывает один час. Естественный ключ — `hour_bucket`, `device_id`, `sensor_name`, и `event_id`.

<table><thead><tr><th width="245">Поле</th><th width="115">Тип</th><th>Описание</th></tr></thead><tbody><tr><td><code>hour_bucket</code></td><td>метка времени</td><td>Начало временного бакета, который агрегирует строка. Во встроенном преобразовании всегда выровнено по границе часа в UTC. В пользовательских преобразованиях с другим размером бакета это начало бакета на выбранном уровне детализации (например, начало 5-минутного окна).</td></tr><tr><td><code>device_id</code></td><td>integer</td><td>Идентификатор устройства. Чтобы получить метку объекта без размножения строк, присоедините к <code>raw_business_data.objects</code> по <code>device_id</code> where <code>is_deleted = false</code>.</td></tr><tr><td><code>sensor_name</code></td><td>текст</td><td>Идентификатор исходного входа из <code>raw_telematics_data.inputs</code>. Соответствует <code>sensor_description.input_label</code> когда датчик настроен.</td></tr><tr><td><code>event_id</code></td><td>integer</td><td>Идентификатор типа события для показания датчика.</td></tr><tr><td><code>sensor_id</code></td><td>integer</td><td>Идентификатор сущности датчика из <code>raw_business_data.sensor_description</code>. Null, если датчик не настроен.</td></tr><tr><td><code>input_label</code></td><td>текст</td><td>Настроенная метка входа из <code>sensor_description</code>. Соответствует <code>sensor_name</code> при наличии.</td></tr><tr><td><code>sensor_label</code></td><td>текст</td><td>Человекочитаемое имя датчика, заданное пользователем.</td></tr><tr><td><code>sensor_type</code></td><td>текст</td><td>Тип датчика, например <code>Уровень топлива</code>, <code>температура</code>, <code>зажигание</code>.</td></tr><tr><td><code>sensor_units</code></td><td>текст</td><td>Строка единицы измерения, введенная пользователем, когда <code>units_type</code> установлено значение «пользовательское». В противном случае пусто.</td></tr><tr><td><code>units_type</code></td><td>integer</td><td>Цифровой код категории объекта. Преобразуется в удобочитаемую строку в <code>sensor_description_units_type</code>.</td></tr><tr><td><code>тип группы</code></td><td>integer</td><td>Код правила агрегации для сгруппированных датчиков: 0 для суммы, 1 для среднего значения. Определяется в <code>sensor_description_Группа_type</code>.</td></tr><tr><td><code>value_avg</code></td><td>число с плавающей запятой</td><td>Среднее декодированного значения датчика по всем измерениям в бакете.</td></tr><tr><td><code>value_min</code></td><td>число с плавающей запятой</td><td>Минимальное декодированное значение в бакете.</td></tr><tr><td><code>value_max</code></td><td>число с плавающей запятой</td><td>Максимальное декодированное значение в бакете.</td></tr><tr><td><code>val_low_avg</code>, <code>val_high_avg</code>, <code>vol_low_avg</code>, <code>vol_high_avg</code></td><td>numeric</td><td>Точки калибровки, используемые при интерполяции <code>calibrated_volume_avg</code>. Только для датчиков уровня топлива; иначе null.</td></tr><tr><td><code>calibrated_volume_avg</code></td><td>numeric</td><td>Откалиброванный объем, соответствующий <code>value_avg</code>, вычисленный линейной интерполяцией между точками калибровки. Для датчиков, не относящихся к датчикам уровня топлива, это равно <code>value_avg</code>.</td></tr><tr><td><code>val_low_min</code>, <code>val_high_min</code>, <code>vol_low_min</code>, <code>vol_high_min</code>, <code>calibrated_volume_min</code></td><td>numeric</td><td>Точки калибровки и интерполированный объем для <code>value_min</code>.</td></tr><tr><td><code>val_low_max</code>, <code>val_high_max</code>, <code>vol_low_max</code>, <code>vol_high_max</code>, <code>calibrated_volume_max</code></td><td>numeric</td><td>Точки калибровки и интерполированный объем для <code>value_max</code>.</td></tr><tr><td><code>Объект_лейбл</code></td><td>текст</td><td>Метка объекта из <code>raw_business_data.objects</code>. Может появляться несколько раз для одного и того же бакета, если устройство исторически было переназначено между объектами.</td></tr><tr><td><code>sensor_description_units_type</code></td><td>текст</td><td>Читаемая человеком категория единиц, определяемая по <code>units_type</code>.</td></tr><tr><td><code>sensor_description_Группа_type</code></td><td>текст</td><td>Читаемое человеком правило группировки, определяемое по <code>тип группы</code>.</td></tr><tr><td><code>sensor_units_final</code></td><td>текст</td><td>Строка единицы измерения для отображения. Равна <code>sensor_units</code> если задано, иначе используется <code>sensor_description_units_type</code>.</td></tr><tr><td><code>value_title</code></td><td>текст</td><td>Читаемая человеком метка для дискретных датчиков, подбираемая из <code>parameters.value_titles</code> using <code>value_max</code> в качестве ключа. Null для измерительных датчиков.</td></tr></tbody></table>

Ниже приведены примеры распространенных запросов. Первый возвращает почасовые агрегаты за последние 7 дней. Второй соединяется с `raw_business_data.objects` чтобы включить метку объекта без дублирования строк. Третий фокусируется на датчиках уровня топлива и использует столбцы откалиброванного объема.

{% tabs %}
{% tab title="Базовый почасовой запрос" %}
{% code overflow="wrap" expandable="true" %}

```sql
SELECT
    device_id,
    hour_bucket,
    sensor_label,
    sensor_type,
    value_avg,
    value_min,
    value_max,
    sensor_units_final
FROM processed_common_data.sensors_data_by_hours
WHERE hour_bucket >= CURRENT_DATE - INTERVAL '7 days'
ORDER BY device_id, hour_bucket, sensor_label;
```

{% endcode %}
{% endtab %}

{% tab title="С меткой объекта" %}
{% code overflow="wrap" expandable="true" %}

```sql
SELECT
    s.device_id,
    o.object_label,
    s.hour_bucket,
    s.sensor_label,
    s.value_avg,
    s.sensor_units_final
FROM processed_common_data.sensors_data_by_hours s
LEFT JOIN raw_business_data.objects o
    ON o.device_id = s.device_id
   AND o.is_deleted = false
WHERE s.hour_bucket >= CURRENT_DATE - INTERVAL '7 days'
ORDER BY s.device_id, s.hour_bucket, s.sensor_label;
```

{% endcode %}
{% endtab %}

{% tab title="Датчики уровня топлива с калиброванным объемом" %}
{% code overflow="wrap" expandable="true" %}

```sql
SELECT
    device_id,
    hour_bucket,
    sensor_label,
    value_avg AS raw_avg,
    calibrated_volume_avg AS volume_avg_litres,
    calibrated_volume_min AS volume_min_litres,
    calibrated_volume_max AS volume_max_litres
FROM processed_common_data.sensors_data_by_hours
WHERE sensor_type = 'fuel_level'
  AND hour_bucket >= CURRENT_DATE - INTERVAL '24 hours'
ORDER BY device_id, hour_bucket;
```

{% endcode %}
{% endtab %}
{% endtabs %}

### Как создаются агрегаты датчиков

Строка в этой таблице — не сырое показание устройства, а производная сущность, собранная из множества отдельных показаний датчиков. Преобразование работает через Сырые данные по этапам: определение, какие показания пригодны для использования, объединение конфигурации датчиков, декодирование значения, группировка по временным окнам, агрегация, применение калибровки уровня топлива и, наконец, обогащение человекочитаемыми метками. Понимание этого процесса помогает вам правильно интерпретировать результаты и понимать, когда поведение по умолчанию нужно настроить под ваш случай использования.

Вот шаги алгоритма, который формирует агрегированную строку датчика:

{% stepper %}
{% step %}

#### **Чтение и фильтрация сырых входных данных**

Преобразование считывает самый последний фрагмент данных из `raw_telematics_data.inputs`. Длина фрагмента соответствует настроенному интервалу: встроенный запуск считывает последний час; пользовательский запуск с интервалом 5 минут считывает последние 5 минут. Считывания фильтруются перед любой дальнейшей обработкой:

* Только значения, соответствующие регулярному выражению `^[0-9]+\.?[0-9]*$` проходят. Это допускает неотрицательные целые числа и десятичные дроби.
* Текстовые значения, отрицательные числа, научная нотация и значения null исключаются.
* Датчики, которые передают только нечисловые данные, не отображаются в выходной таблице.

Фильтр работает с сырыми `value` столбец в `входы`, до применения какого-либо декодирования.
{% endstep %}

{% step %}

#### **Объединение конфигурации датчика**

Каждое оставшееся значение сопоставляется с `raw_business_data.sensor_description` с использованием `LEFT JOIN` по `device_id` и `input_label = sensor_name`. Объединение добавляет `sensor_id`, `sensor_label`, `sensor_type`, `units_type`, `тип группы`, `divider`, `multiplier`, `calibration_data`, и `параметры`. Поскольку соединение левостороннее, показания с ненастроенных датчиков все равно проходят дальше, а метаданные датчика равны null.
{% endstep %}

{% step %}

#### **Декодирование необработанного значения**

Каждое показание преобразуется из сохраненного представления в пригодное для использования числовое значение. Правило декодирования берется из `sensor_description.parameters.calc_method`:

* `bit_index` извлекает один бит из целочисленного значения с помощью сдвига битов и маски: `((raw_value::bigint >> bit_index) & 1)`. Используется для флагов статуса, упакованных в целые числа.
* `тождественное преобразование` использует исходное числовое значение без изменений.
* В противном случае функция применяет `(raw_value / divider) * multiplier`, что является стандартной формулой для измерительных датчиков. Делитель, равный null, вызывает переход по умолчанию к сырому значению. `COALESCE` к сырому значению.
  {% endstep %}

{% step %}

#### **Группировка по интервалам и агрегация**

Декодированные значения группируются по временным интервалам путем усечения `device_time` до границы интервала. Внутри каждого интервала функция вычисляет `AVG`, `MIN`, и `MAX` декодированного значения. Группировка также включает столбцы метаданных датчика, поэтому агрегаты вычисляются для каждого датчика, для каждого устройства и для каждого интервала.

Во встроенном преобразовании интервал составляет один час. Пользовательские преобразования могут использовать любой положительный интервал. См. [Настройка преобразования](https://claude.ai/chat/32cacafe-fe34-476d-b7d0-c93b4ce82da6#customizing-the-transformation) ниже.
{% endstep %}

{% step %}

#### **Калибровка датчиков уровня топлива**

Датчики с заполненным `calibration_data` массивом (обычно датчики уровня топлива) получают линейную интерполяцию для каждого агрегата. Для `value_avg`, `value_min`, и `value_max` отдельно функция находит точки калибровки непосредственно ниже и непосредственно выше значения, затем линейно интерполирует, чтобы получить `calibrated_volume_avg`, `calibrated_volume_min`, и `calibrated_volume_max`. Для датчиков без данных калибровки откалиброванные объемы равны сырым агрегированным значениям.

Столбцы точек разбиения (`val_low_*`, `val_high_*`, `vol_low_*`, `vol_high_*`) сохраняются в выходных данных для наглядности.
{% endstep %}

{% step %}

#### **Обогащение метками**

Агрегированные строки соединяются с `raw_business_data.objects` по `device_id` чтобы добавить `Объект_лейбл`, и с `raw_business_data.description_parameters` дважды, чтобы преобразовать `units_type` и `тип группы` в удобочитаемые строки описания. Функция также вычисляет `sensor_units_final`, которое отдает приоритет введенному пользователем `sensor_units` и в противном случае использует строку описания.

Для дискретных датчиков с `parameters.value_titles` сопоставлением функция находит удобочитаемый заголовок, соответствующий `value_max` и возвращает его как `value_title`. Измерительные датчики имеют `value_title` значение null.
{% endstep %}
{% endstepper %}

Следующие два справочных раздела содержат настраиваемый параметр интервала и правила декодирования, которые преобразование применяет внутри себя.

<details>

<summary>Параметр интервала</summary>

Преобразование управляется одним параметром, `p_interval`, который определяет как размер интервала, так и окно просмотра назад. Эти два значения всегда равны: запуск с `p_interval = '5 minutes'` считывает последние 5 minutes сырых данных и формирует 5-минутные интервалы.

| Настройка                | Встроенное преобразование                    | Пользовательское преобразование                                                    |
| ------------------------ | -------------------------------------------- | ---------------------------------------------------------------------------------- |
| Размер интервала         | 1 час                                        | Любой положительный интервал, заданный в Узле Custom SQL                           |
| Окно просмотра назад     | 1 час                                        | Равно размеру интервала                                                            |
| Периодичность расписания | Каждый час (соответствует размеру интервала) | Сопоставьте с выбранным размером интервала для непрерывного покрытия без пропусков |

Смотрите [Настройка преобразования](#customizing-the-transformation) для инструкций по изменению интервала.

</details>

<details>

<summary>Правила декодирования значений</summary>

Сырые значения датчиков поступают в виде текста в `raw_telematics_data.inputs.value`. Преобразование применяет правило декодирования на основе конфигурации каждого датчика перед агрегацией.

| `calc_method`                  | Поведение декодирования                                                                                             |
| ------------------------------ | ------------------------------------------------------------------------------------------------------------------- |
| `bit_index`                    | Извлекает один бит: `((value::bigint >> bit_index) & 1)`. Поле `bit_index` считывается из `параметры`.              |
| `тождественное преобразование` | Использует сырое значение как float, без изменений.                                                                 |
| (по умолчанию / нет)           | Применяет `(raw_value / divider) * multiplier`. Если делитель равен null, запускается `COALESCE` к сырому значению. |

калибровочная интерполяция, применяемая после агрегации для датчиков с данными калибровки, работает путем поиска опорных точек в `calibration_data` (массиве JSONB из `{in, out}` записей), ближайших к агрегированному значению, и линейной интерполяции между ними. Результат сохраняется в `calibrated_volume_*` столбцах.

</details>

### Настройка преобразования

Стандартная агрегация Данные датчиков отражает общую почасовую агрегацию Navixy. Если в вашем операционном сценарии требуется другая детализация, например более высокая разрешающая способность для панелей мониторинга диагностики или более крупные интервалы для долгосрочной отчетности, вы можете создать пользовательское преобразование, которое вызывает `select_timeperiod_sensor_data` с другим интервалом и записывает результат в вашу собственную таблицу в `processed_custom_data`.

Настройка выполняется одной строкой в Узле Custom SQL:

```sql
SELECT * FROM processed_common_data.select_timeperiod_sensor_data('5 minutes')
```

Измените литерал интервала, чтобы управлять одновременно размером интервала и окном просмотра назад. Функция возвращает одинаковую структуру столбцов независимо от интервала, поэтому настройка выходного Узла остается простой.

{% hint style="warning" %}
Значение интервала одновременно управляет размером интервала и окном просмотра назад. Их нельзя задать независимо. Расписание рабочего процесса должно запускаться не реже, чем интервал, иначе некоторые показания не будут агрегированы.
{% endhint %}

#### Структура рабочего процесса

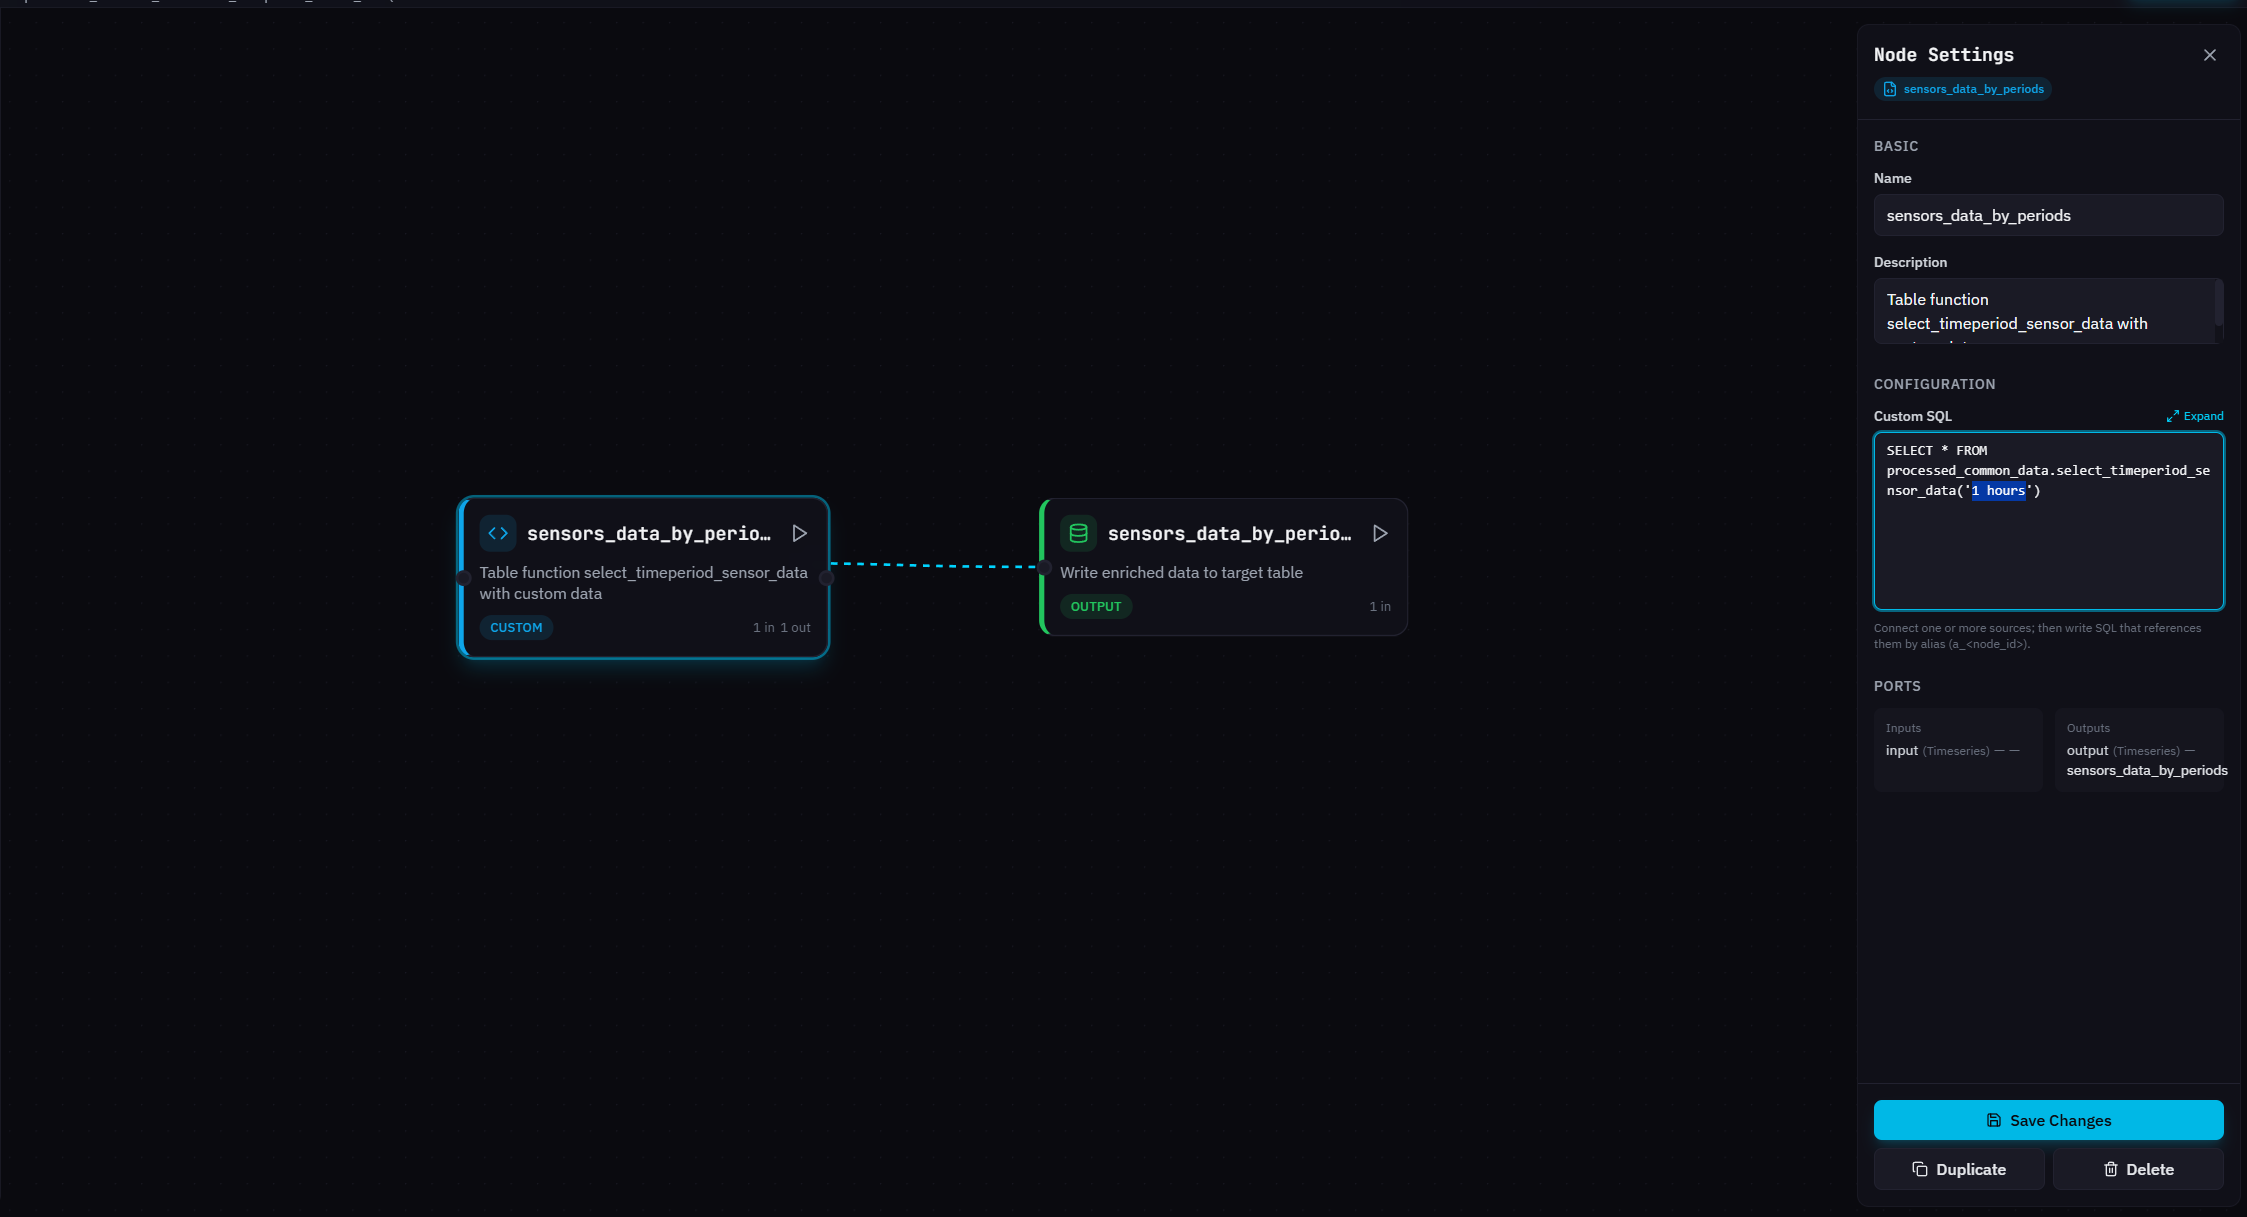
Минимальный рабочий процесс состоит из двух Узлов:

<figure><img src="https://1999959041-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FoFNFEIINiGFbhi3Px3dE%2Fuploads%2Fgit-blob-2160d1986b61ca2e36061e3889caf87b1a905d59%2FSensor-data-aggregation-custom-timeframe.png?alt=media" alt=""><figcaption></figcaption></figure>

Не `Сырые данные: телематика` требуется исходный Узел. Функция читает из `raw_telematics_data.inputs` и `raw_business_data` таблиц внутри системы. Узел Custom SQL содержит весь конвейер, а Узел Output материализует результат в целевую таблицу.

#### Примеры настройки

Разверните разделы ниже, чтобы увидеть примеры настройки в конкретных случаях.

<details>

<summary>Изменение размера интервала</summary>

Используйте это, когда почасовая детализация слишком груба для ваших потребностей в отчетности. Типичные случаи включают панели мониторинга, показывающие динамику уровня топлива с разрешением 5 минут, посекундную диагностику для коротких тестовых поездок и дневные сводки для долгосрочной отчетности.

Чтобы изменить размер интервала, измените литерал интервала в Узле Custom SQL и обновите расписание, чтобы оно ему соответствовало.

* **5-минутные интервалы**, по расписанию `*/5 * * * *` (каждые 5 минут):

```sql
SELECT * FROM processed_common_data.select_timeperiod_sensor_data('5 minutes')
```

* **Пятнадцатиминутные интервалы**, по расписанию `*/15 * * * *` (каждые 15 минут):

```sql
SELECT * FROM processed_common_data.select_timeperiod_sensor_data('15 minutes')
```

* **Суточные интервалы**, по расписанию `5 0 * * *` (каждый день в 00:05 UTC):

```sql
SELECT * FROM processed_common_data.select_timeperiod_sensor_data('1 day')
```

Выходной столбец по-прежнему называется `hour_bucket` независимо от интервала. Если вы хотите более понятное имя в вашей пользовательской таблице, задайте псевдоним в Custom SQL:

```sql
SELECT
    hour_bucket AS bucket_time,
    device_id, sensor_name, event_id,
    sensor_id, input_label, sensor_label,
    sensor_type, sensor_units, units_type, group_type,
    value_avg, value_min, value_max,
    объект_label, датчик_units_final
FROM processed_common_data.select_timeperiod_sensor_data('5 minutes')
```

Установите у Узла Output **Столбец времени** к `bucket_time` если вы задаете псевдоним, или чтобы `hour_bucket` если вы сохраняете исходное имя.

</details>

<details>

<summary>Ограничение по конкретным датчикам</summary>

Используйте это, когда вам нужны только агрегированные данные для подмножества датчиков, например только Уровень топлива и температура двигателя, чтобы уменьшить размер таблицы и стоимость запроса.

Оберните вызов функции в фильтрующее `SELECT` внутри Узел Custom SQL:

```sql
SELECT *
FROM processed_common_data.select_timeperiod_sensor_data('15 minutes')
WHERE sensor_type IN ('fuel_level', 'temperature')
```

Вы можете фильтровать по любому столбцу, который возвращает функция, включая `sensor_label`, `sensor_name`, или `sensor_id`. Чтобы найти значения, доступные в ваших данных, выполните запрос к исходной таблице:

```sql
SELECT DISTINCT sensor_name FROM raw_telematics_data.inputs LIMIT 100;
```

</details>

<details>

<summary>Сведение вывода к необходимым столбцам</summary>

Используйте это, когда вам не нужны точки калибровки или столбец дискретного датчика `value_title` столбца, и хотите более компактную таблицу вывода. Это особенно полезно, когда в вашем автопарке нет датчиков уровня топлива, в этом случае все 15 столбцов, связанных с калибровкой, либо null, либо дубликаты сырых агрегатов.

Выводите только нужные вам столбцы:

```sql
SELECT
    hour_bucket,
    device_id,
    sensor_name,
    event_id,
    sensor_label,
    sensor_type,
    value_avg,
    value_min,
    value_max,
    Объект_label,
    sensor_units_final
FROM processed_common_data.select_timeperiod_sensor_data('15 minutes')
```

Конфигурация узла вывода остается прежней; в целевой таблице просто будет меньше столбцов.

</details>

#### Конфигурация узла вывода

После настройки узла Custom SQL подключите его к узлу вывода и настройте целевую таблицу.

<table><thead><tr><th width="180">Параметр</th><th>Значение</th></tr></thead><tbody><tr><td><strong>Имя таблицы</strong></td><td>Описательное имя, например <code>sensors_data_by_5min</code></td></tr><tr><td><strong>Столбец времени</strong></td><td><code>hour_bucket</code> (или ваш псевдоним, если вы переименовали его)</td></tr><tr><td><strong>Первичный ключ</strong></td><td><code>device_id</code>, <code>hour_bucket</code>, <code>sensor_name</code>, <code>event_id</code></td></tr><tr><td><strong>Разбиение по</strong></td><td><code>DATE(hour_bucket)</code></td></tr><tr><td><strong>Режим записи</strong></td><td><code>append</code></td></tr></tbody></table>

Первичный ключ должен включать все четыре столбца естественного ключа функции. Использование только `device_id` и `hour_bucket` приведет к нарушениям первичного ключа, потому что у каждого устройства есть несколько датчиков, отправляющих данные в одном и том же интервале. `append` является правильным режимом записи, когда расписание совпадает с размером интервала, потому что каждый запуск создает новые интервалы, которые еще не были записаны. Используйте `upsert` только если ваши запуски перекрываются (например, 15-минутный интервал, запускаемый каждые 5 минут).

#### Планирование

Периодичность расписания должна быть равна значению интервала. Тогда каждый запуск считывает ровно объем данных одного бакета без наложения и без пропусков.

| Размер интервала | Выражение расписания | Значение                |
| ---------------- | -------------------- | ----------------------- |
| 1 минута         | `* * * * *`          | Каждую минуту           |
| 5 минут          | `*/5 * * * *`        | Каждые 5 минут          |
| 15 minutes       | `*/15 * * * *`       | Каждые 15 минут         |
| 1 час            | `0 * * * *`          | Каждый час в 00 минут   |
| 1 день           | `5 0 * * *`          | Каждый день в 00:05 UTC |

Время указано в UTC. Сопоставьте периодичность cron с вашим интервалом; запуск реже, чем интервал, оставит пропуски в выходной таблице, а запуск чаще приведет к конфликтам из-за дубликатов первичного ключа в `append` режиме.

#### Использование шаблона рабочего процесса

Navixy предоставляет готовый шаблон рабочего процесса, который можно загрузить в Transformation Builder в качестве отправной точки. Шаблон поставляется с Узел Custom SQL, предварительно настроенным для 5-минутных бакетов.

См. [Шаблоны](/docs/analytics/ru/iot-query/schema-overview/transformation-layer/transformation-builder/templates.md) страницу с инструкциями по загрузке, импорту и конфигурацией Узла Output для этого преобразования.

### Следующие шаги

* [**Общие преобразования**](/docs/analytics/ru/iot-query/schema-overview/transformation-layer/common-transformations.md): Назад к индексу преобразований.
* [**Шаблоны**](/docs/analytics/ru/iot-query/schema-overview/transformation-layer/transformation-builder/templates.md): Загрузите шаблон рабочего процесса агрегации Данные датчиков и импортируйте его в Transformation Builder.
* [**Конструктор трансформаций**](/docs/analytics/ru/iot-query/schema-overview/transformation-layer/transformation-builder.md): Узнайте, как работать с визуальным редактором рабочего процесса, добавлять Узлы и просматривать результаты.
* [**Слой сырых данных**](/docs/analytics/ru/iot-query/schema-overview/bronze-layer.md): Изучите исходные таблицы, которые поступают в агрегацию Данные датчиков: `raw_telematics_data.inputs`, `raw_business_data.sensor_description`, и `raw_business_data.objects`.
* [**Поездки**](/docs/analytics/ru/iot-query/schema-overview/transformation-layer/common-transformations/trips.md): Соседнее преобразование, которое создает записи поездок транспортных средств из необработанных телематических данных.


---

# Agent Instructions
This documentation is published with GitBook. GitBook is the documentation platform designed so that both humans and AI agents can read, navigate, and reason over technical content effectively. Learn more at gitbook.com.

## Querying This Documentation
If you need additional information that is not directly available in this page, you can query the documentation by asking a question.

Perform an HTTP GET request on the following URL with the `ask` and `goal` query parameters:

```
GET https://navixy.com/docs/analytics/ru/iot-query/schema-overview/transformation-layer/common-transformations/sensor-data-aggregation.md?ask=<question>&goal=<user_goal>
```

`ask` is the immediate question: it should be specific, self-contained, and written in natural language.
`goal` is what the user is ultimately trying to achieve, the reason they need the answer. Sharing it helps GitBook give you a better, more relevant answer. A goal is most helpful when it describes the outcome the user wants rather than restating the question. For example, with `ask=how do I create an API token`, a goal like `automate deployments from our CI pipeline` lets GitBook tailor the answer to that use case.

The response will contain a direct answer to the question and relevant excerpts and sources from the documentation.

Use this mechanism when the answer is not explicitly present in the current page, you need clarification or additional context, or you want to retrieve related documentation sections.