Comment nous développons notre analytique conversationnelle de flotte

AuteurAndrew M., VP of Data and Solutions
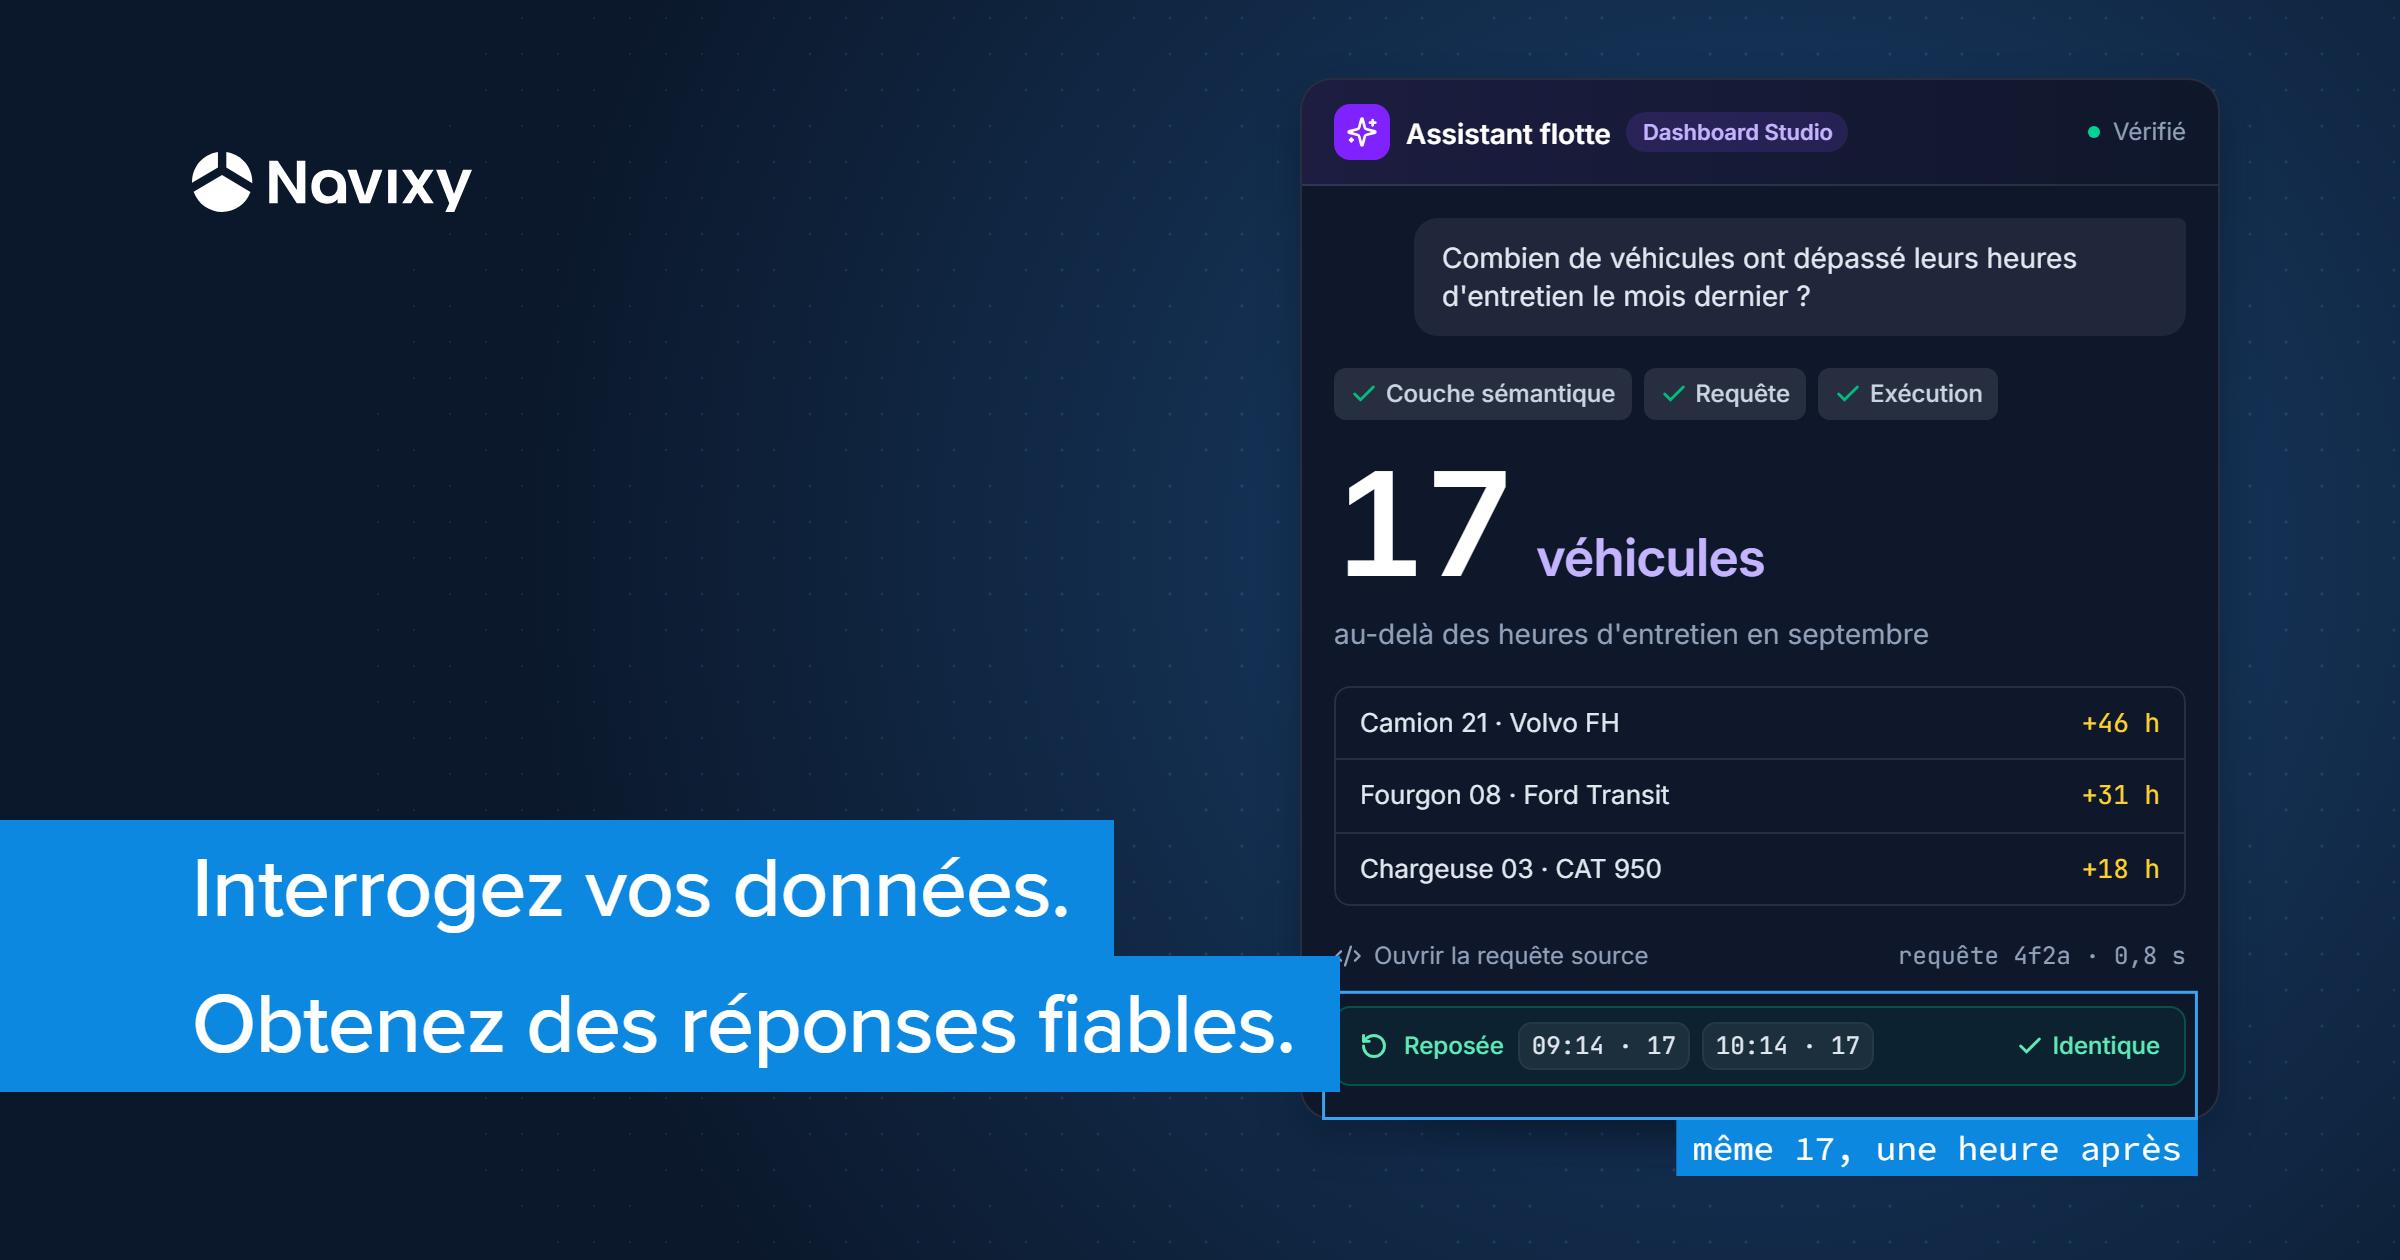
L'analytique conversationnelle est l'étape suivante au-delà des tableaux de bord pour comprendre comment une flotte fonctionne réellement — et soyons honnêtes, la plupart des tableaux de bord ne sont jamais étudiés en profondeur. Avec un agent IA intégré à votre système d'analyse, un utilisateur peut poser une question en langage naturel, obtenir l'information dont il a besoin immédiatement et approfondir les détails par lui-même.
Navixy avance dans cette direction. L'agent IA intégré à notre outil de BI Dashboard Studio construit déjà des tableaux de bord à partir de requêtes en langage naturel. Mais un assistant textuel basé sur un grand modèle de langage (LLM) n'est pas toujours précis, et notre objectif principal est donc de s'assurer que chaque réponse est correcte et à jour.
La fiabilité de l'analytique conversationnelle est avant tout un problème d'architecture, pas de chatbot. Nous continuons à améliorer notre agent et nous voulons partager comment nous procédons.
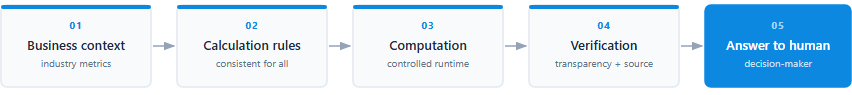
Chez Navixy, notre approche de l'analytique conversationnelle repose sur cinq couches, chacune éliminant une cause spécifique d'erreurs dans les réponses de l'IA :
1. Contexte : enseigner au fleet AI votre vocabulaire de télématique
Les modèles de langage comprennent le langage naturel. Mais ils ne savent pas comment un terme est défini dans votre plateforme ou dans les processus métier d'un client — et le coût de cet écart est mesurable. Les recherches du secteur montrent de façon constante que router les requêtes via une couche sémantique de métriques prédéfinie réduit les taux d'erreur de l'agent jusqu'aux deux tiers. Cette couche comble l'écart entre le langage universel et le contexte propre à chaque entreprise.
L'objectif n'est pas de « connecter le LLM à une base de données de télémétrie ». C'est d'apprendre au système ce que ces données signifient pour chaque client spécifique.
La surveillance de flotte regorge de termes qui ne semblent qu'univoques. Quelques exemples :
- Ce que signifie « en ligne » : le tracker a-t-il envoyé un message au cours de la dernière heure, ou a-t-il signalé une position GPS valide ?
- Le « temps de ralenti » compte-t-il une période où le moteur tourne mais la vitesse est nulle ? Et quel seuil doit être dépassé ?
- Un « trajet » est-il défini par le démarrage et l'arrêt du moteur, ou par le mouvement réel ? Consultez l'article de documentation sur la façon de définir et d'ajuster les paramètres de trajet dans la plateforme.
Quand deux équipes utilisent le même mot pour deux calculs différents, le système peut produire une réponse erronée en toute confiance. Dans une solution multi-clients, les définitions diffèrent également d'un client à l'autre.
2. Exécution : laisser un environnement contrôlé faire les calculs
Les modèles d'IA excellent à générer du texte. Mais ce ne sont pas des moteurs de calcul déterministes. Posez la même question sur une métrique numérique deux fois et vous pouvez obtenir deux réponses différentes. Cela devient un problème quand ces métriques — kilométrage, heures moteur ou consommation de carburant — sont celles que les clients utilisent dans leurs rapports, comparaisons ou facturation.
Alors ne demandez pas au modèle d'IA de « calculer » quelque chose. Il vaut mieux commencer par lui demander de formuler la logique de calcul et d'obtenir la confirmation de l'utilisateur, puis laisser le calcul réel être exécuté par un algorithme ou un script dans un environnement d'exécution contrôlé. C'est là que la qualité de ces opérations est substantiellement plus élevée.
Un schéma fiable ressemble à ceci :
Comprendre → Planifier → Générer la requête/le code → Exécuter → Inspecter → Expliquer.
L'exécution de code rend également la réponse transparente et reproductible. L'équipe technique peut examiner le code derrière une réponse, le vérifier et reproduire le résultat — plutôt que de simplement prendre le modèle au mot.
3. Validation : commencer étroit, élargir lentement
Les assistants IA gèrent bien les questions spécifiques. Mais ouvrez la porte au « pose n'importe quelle question », et les réponses tendent à être inapplicables plutôt qu'utiles.
Prenez l'analytique de flotte dans Dashboard Studio et comparez deux requêtes.
| « Combien d'appareils étaient en ligne hier ? » | « Qu'est-ce qui ne va pas avec la flotte ? » |
|---|---|
| ✓ règles claires ✓ réponse vérifiable ✓ comparable aux données de la plateforme |
✗ aucune règle définie ✗ le système construit sa propre interprétation ✗ la réponse est difficile à vérifier |
Une approche plus fiable consiste à commencer par des scénarios spécifiques, évalués sur des exemples de référence, que les clients posent le plus souvent. Pour évaluer les résultats d'un agent IA, quatre critères doivent être satisfaits simultanément :
- Exactitude : la réponse est-elle correcte ?
- Reproductibilité : tient-elle lors d'une répétition ?
- Ancrage : remonte-t-elle à des données réelles ?
- Respect du périmètre : le système est-il resté dans ce qu'il peut répondre de manière fiable ?
Chez Navixy, nous élargissons le périmètre uniquement quand le système satisfait les quatre critères. Nous faisons croître les capacités du système d'analyse graduellement — jamais en avance sur la confiance construite autour de lui.
4. Transparence : montrer comment la réponse a été obtenue
Une réponse correcte et une réponse fiable sont deux problèmes différents. La transparence comble l'écart entre les deux et tient votre équipe de support à l'écart de chaque ticket « pourquoi le chiffre dit ça ? ».
Un test simple : un utilisateur non technique — un répartiteur ou un responsable des opérations, pas un ingénieur — peut-il comprendre d'où provient la valeur d'une métrique en 20 à 30 secondes ? Si ce n'est pas le cas, le problème de confiance n'est pas encore résolu. Toute personne travaillant avec un système d'analytique conversationnelle devrait pouvoir voir, assez rapidement, comment et sur quelles données repose une réponse.
Quand les gens voient régulièrement la logique derrière les calculs, ils construisent un meilleur modèle mental de ce que le système peut et ne peut pas faire, et commencent à poser des questions plus précises. Cela crée une boucle de rétroaction continue.
Au final, la transparence devient une partie du produit. Elle est également requise pour la gouvernance de l'IA et la responsabilité — des questions que les clients entreprise poseront toujours.
5. Gouvernance : adapter l'autonomie au coût d'une erreur
Un assistant IA répond à chaque question avec la même confiance, mais le coût d'une erreur n'est pas le même pour chaque question. Plus le contrôle doit être strict, plus le coût d'une erreur est élevé.
- Risque faible — résumés, comparaisons, exploration ouverte des trajets et de l'utilisation. Ces tâches peuvent largement fonctionner en pilote automatique. Un chiffre légèrement erroné se corrige à la prochaine question.
- Risque moyen — recommandations, interprétation d'anomalies (une baisse inhabituelle de carburant ou un écart de route), décisions opérationnelles. Celles-ci méritent plus d'examen, car quelqu'un va agir sur le résultat.
- Risque élevé — sécurité, conformité, exposition financière, maintenance critique. Des garde-fous réels sont requis ici. Une mauvaise réponse n'est pas un désagrément, c'est un incident. L'IA ne doit jamais deviner : toute incertitude doit immédiatement transmettre la question à un expert humain.
Une bonne valeur par défaut est la répartition de Pareto : pour environ 80 % des tâches routinières, les utilisateurs peuvent examiner le résultat eux-mêmes, tandis que les 20 % de décisions à enjeux élevés nécessitent des contrôles plus stricts.
Une analytique conversationnelle digne de confiance
L'équipe Navixy construit l'architecture de son système d'analytique conversationnelle non pas autour d'un dialogue soigné — mais autour de la confiance. D'abord, le système reçoit le contexte métier. Puis il le traduit en règles de calcul vérifiées qui régissent chaque computation. Les computations s'exécutent de manière contrôlée et transparente. Chaque résultat est vérifié et immédiatement présenté avec les données sur lesquelles il repose. C'est seulement alors que la réponse atteint l'humain qui prend la décision.
L'expérience « chatter avec vos données » que les utilisateurs remarquent n'est que la surface. Le vrai avantage vient quand le système peut non seulement répondre, mais expliquer, vérifier ses données et faire appel à un humain là où une attention est nécessaire. C'est ce que les clients continuent d'utiliser — parce que cela les aide à prendre des décisions en toute confiance.
Prêt à mettre ces cinq couches en œuvre ? Parlez-nous de la construction de solutions IA pour flottes auxquelles vos clients peuvent faire confiance.
Sur cette page
- 1. Contexte : enseigner au fleet AI votre vocabulaire de télématique
- 2. Exécution : laisser un environnement contrôlé faire les calculs
- 3. Validation : commencer étroit, élargir lentement
- 4. Transparence : montrer comment la réponse a été obtenue
- 5. Gouvernance : adapter l'autonomie au coût d'une erreur
- Une analytique conversationnelle digne de confiance