Construisez un modèle de données à l'image de votre activité télématique avec Business Data Repository
Une plateforme télématique démarre généralement avec un ensemble d'objets familiers : véhicules, appareils, conducteurs, géofences.
Or les opérations réelles d'un client s'arrêtent rarement là.
Une entreprise de logistique peut aussi avoir besoin de remorques, de contrats, de dépôts, de types de marchandises et de fiches de maintenance. Une société de location travaille peut-être avec des agences, des catégories d'équipements, des clients et des unités de location. Un intégrateur système peut avoir besoin de relier au même actif physique des informations issues de plusieurs systèmes métier.
C'est là qu'un modèle de données rigide commence à poser problème.
Vous pouvez ajouter une seconde base de données à côté de la plateforme télématique. Vous pouvez encoder les données métier dans des notes et des étiquettes. Ou vous pouvez construire une couche de synchronisation qui traduit en permanence le modèle du client vers celui de la plateforme, et inversement.
Ces trois approches fonctionnent. Aucune ne vieillit bien.
Prenons une configuration logistique courante : un camion peut travailler avec différentes remorques, et chaque remorque peut embarquer ses propres équipements de suivi et de mesure. L'entreprise a besoin de savoir non seulement où se trouve le camion, mais quelle remorque y est attelée, quels appareils appartiennent à cette remorque et quelles données d'exploitation sont associées à chaque élément de l'ensemble.
Dans un modèle de données rigide, représenter ces relations passe généralement par des tables supplémentaires, des identifiants dupliqués ou une logique de synchronisation située en dehors de la plateforme télématique.
Business Data Repository est développé pour modéliser cette structure directement. Un intégrateur peut définir des camions, des remorques, des équipements, des contrats ou d'autres objets métier, les relier par des relations explicites, et étendre chaque type avec les attributs dont son exploitation a besoin. La même approche s'applique ensuite à une flotte de chantier, à une activité de location, à une activité sous chaîne du froid ou à presque n'importe quel autre modèle propre à un client.
L'API GraphQL Repository est le contrat qui rend cette flexibilité possible. Elle donne aux intégrateurs une manière cohérente de définir et de manipuler ces entités métier connectées sans attendre une modification du schéma de la plateforme. Des SDK pour Kotlin, TypeScript et Python sont prévus pour rendre ce même modèle plus facile à utiliser depuis les langages que les intégrateurs livrent déjà, avec un serveur MCP prévu au-dessus des mêmes entités pour les manipuler depuis Navixy et depuis des outils externes.
Un point de contexte important d'emblée : l'API et les SDK Business Data Repository ne sont pas encore disponibles publiquement. La documentation actuelle est une documentation de préversion, et les structures comme les comportements peuvent encore changer avant la sortie. À lire donc comme la direction que prend le modèle et la raison pour laquelle elle compte, et non comme un guide de déploiement en production aujourd'hui.
Le modèle des opérations connectées
Une façon utile de se représenter l'API Business Data Repository, c'est ce modèle à cinq couches :
- Typer — définissez la forme d'objet que votre activité utilise réellement.
- Relier — connectez les enregistrements entre eux par des relations, pas par du texte approximatif.
- Valider — imposez la qualité des données au niveau du type de champ.
- Cataloguer — normalisez une seule fois les vocabulaires contrôlés, puis réutilisez-les partout.
- Tracer — conservez l'historique des modifications pour que le contexte d'exploitation ne se perde pas avec le temps.
Les champs personnalisés en font partie, mais ils ne constituent qu'une seule de ces couches.
Partez des objets métier, pas seulement des objets par défaut de la plateforme
Les champs personnalisés sont utiles, mais ils ne résolvent qu'une partie du problème.
Parfois, ce dont vous avez besoin n'est pas un attribut de plus sur un véhicule. C'est un autre type d'objet dans votre modèle d'exploitation.
Un intégrateur peut par exemple avoir besoin de représenter des remorques, des expéditions, des contrats de service, des unités de location ou des équipements auxiliaires comme des entités métier de plein droit, dans le même environnement de données.
L'API Business Data Repository est conçue pour qu'un espace de travail définisse ses propres types dans deux familles d'objets : les types d'actifs et les types d'objets géographiques. Tout ce qui figure dans la liste ci-dessus — une remorque, une expédition, un contrat de service, une unité de location, un équipement — se modélise comme un type d'actif qui vous appartient, avec ses propres attributs ; les zones, les sites et les secteurs d'intervention sont des types d'objets géographiques.
Plutôt que de faire entrer de force un « contrat de service » dans une note de véhicule ou de le garder uniquement dans une table externe, vous le modélisez directement dans une seule couche connectée.
Cela ne veut pas dire que chaque compte part d'un modèle vierge. À la création d'un compte, le client peut aussi pré-créer des types d'entités prêts à l'emploi, comme Vehicle et Cargo. Ces types arrivent avec un jeu de champs de base, extensible comme n'importe quel autre type — l'objectif est de démarrer plus vite, pas de figer le schéma.
Si vous intégrez pour plusieurs secteurs, cela compte encore davantage. Une entreprise de construction, un opérateur de la chaîne du froid et un loueur d'équipements peuvent utiliser la même plateforme télématique tout en conservant, au-dessus, des modèles métier très différents.
Pour situer la façon dont Navixy modélise aujourd'hui les actifs typés, voir le guide sur l'utilisation des actifs.
Reliez les enregistrements au lieu de stocker des identifiants en texte brut
Créer des enregistrements n'a d'intérêt que s'ils peuvent être reliés de façon significative.
Dans beaucoup de systèmes, un champ comme trailer finit par contenir une valeur texte du type TR-1048. Cette valeur a l'air utile, mais ce n'est qu'une chaîne de caractères. La plateforme ne sait pas pour autant si cette remorque existe, ce qu'elle est, ni ce qui lui est rattaché.
L'API Repository est construite autour de relations par référence entre enregistrements.
Cela change ce que les intégrateurs peuvent construire :
vehicle -> trailerequipment -> service contractshipment -> vehicleasset -> customer, sous forme d'entrée de catalogue ou de type d'actif qui vous appartient
Une référence pointe vers un enregistrement de votre propre modèle : dans ce dernier exemple, le client, le fournisseur ou l'équipe responsable est donc un objet que vous avez modélisé vous-même — une entrée de catalogue ou un type d'actif — et non un compte utilisateur de la plateforme. Mieux vaut trancher tôt, car ce choix détermine la façon dont vous représentez les personnes et les organisations dans tout le modèle.
La distinction est technique, mais ses conséquences sont pratiques. Dès que les liens sont modélisés comme des relations et non comme du texte libre, vos écrans d'exploitation, vos règles et vos API travaillent sur un contexte relié plutôt que sur des fragments isolés.
Ajoutez les attributs correspondant au rôle de chaque objet
Dès lors que les types d'objets existent, les champs personnalisés prennent beaucoup plus de valeur.
Chaque type porte ses propres attributs pertinents, au lieu de partager un unique fourre-tout de « champs supplémentaires ».
Une remorque peut avoir besoin d'un numéro VIN, de limites de charge et de dates de contrôle. Un contrat de service peut avoir besoin d'un numéro de contrat, de dates de validité et d'un statut. Une unité de location peut avoir besoin de champs d'utilisation et de remise.
Le contrat de préversion actuel définit un système de champs typés avec un comportement de validation (par exemple des bornes de longueur pour les chaînes, des contraintes numériques pour les décimaux et des valeurs restreintes pour les options et les références). Le modèle applique ainsi une partie de la logique métier, au lieu de reporter toute la validation dans chaque application cliente.
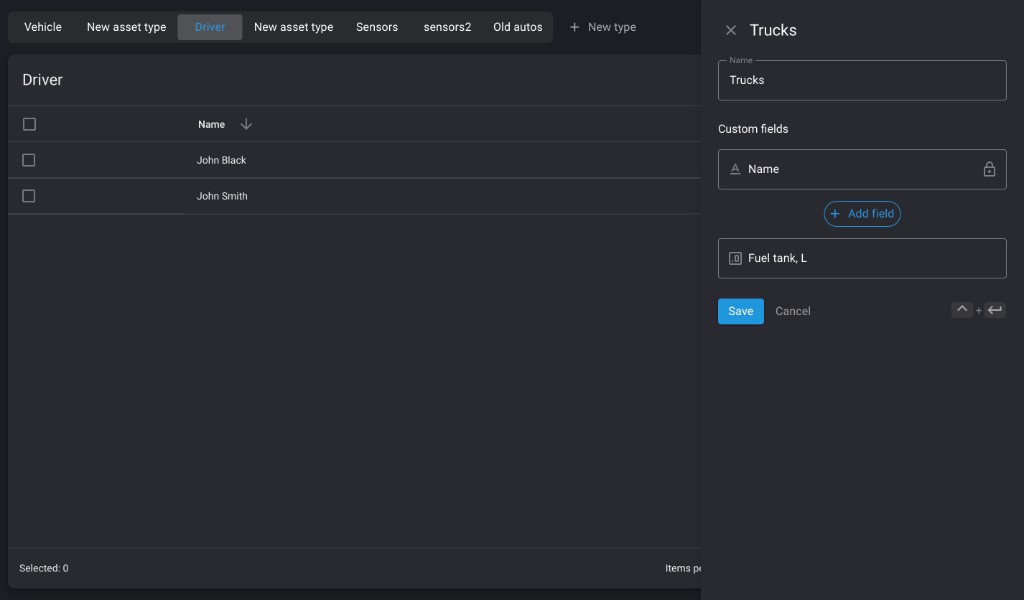
Une décision est définitive dans cette conception, et mieux vaut l'anticiper : le type d'un champ est figé au moment de sa création. Les intitulés, les bornes de validation et le caractère obligatoire restent modifiables, et un champ que vous n'utilisez plus peut être archivé puis restauré.
Le type, lui, fait exception : faire passer un champ de texte à référence, ou de nombre à liste d'options, impose de supprimer la définition et d'en créer une nouvelle — et les valeurs déjà écrites sous l'ancienne définition restent dans les données stockées, sans plus rien derrière elles. Choisissez un type comme vous choisiriez le type d'une colonne dans un schéma que vous ne pourrez pas migrer : pour un intégrateur qui conçoit un modèle que ses clients rempliront de vrais enregistrements, c'est la décision la plus coûteuse de cette page.
Pour les détails les plus à jour au fil de l'évolution de la préversion, voir Mettre en œuvre les champs personnalisés.
Utilisez les catalogues pour garder un vocabulaire métier cohérent
Beaucoup d'attributs métier proviennent de vocabulaires contrôlés : fabricants, catégories de service, classes de marchandises, structures d'agences, centres de coûts.
Sans catalogues, les équipes finissent généralement avec des chaînes qui divergent :
BoschBOSCHBosch GmbH
L'API Business Data Repository comprend des structures de catalogue définies par l'utilisateur, afin que ces valeurs soient normalisées une seule fois puis réutilisées d'un objet lié à l'autre.
À mesure que la modélisation propre à chaque client s'étoffe, c'est l'un des plus puissants multiplicateurs de qualité : moins de nettoyage, moins d'écarts, et moins de bugs d'intégration du type « même chose, trois orthographes ».
Conservez le contexte des changements, pas seulement l'état actuel
Dans les flux de travail opérationnels, la valeur actuelle ne suffit souvent pas.
La question qui revient n'est pas « quelle valeur cet objet porte-t-il maintenant ? » mais « quelle valeur portait-il au moment où cet événement s'est produit ? ».
L'API Business Data Repository intègre un contexte de modification orienté historique et audit des entités, pour que les intégrateurs construisent des interfaces où la chronologie et la provenance comptent, et pas seulement le dernier état connu.
Pour l'exploitation interne, les processus réglementés, l'analyse d'incidents et les outils d'administration exposés aux clients, cela peut être bien plus utile qu'un simple jeu de champs modifiables.
Gérez les opérations télématiques courantes avec moins de code de liaison
Les intégrateurs passent souvent du temps sur des tâches d'exploitation répétitives, situées entre le « CRUD simple » et les véritables moteurs de flux de travail.
Le remplacement d'un boîtier télématique en est un bon exemple. Lorsqu'un traceur passe d'un actif à un autre, le modèle de données doit prendre en charge proprement ce changement de relation, au lieu d'imposer une logique de synchronisation fragile, en plusieurs étapes, autour d'identifiants détachés.
Il en va de même lorsque plusieurs appareils sont rattachés et que l'un d'eux doit être clairement désigné comme principal.
Ce ne sont pas, en soi, des promesses spectaculaires. Mais elles traduisent la même orientation de conception : modéliser directement les relations d'exploitation, au lieu de laisser chaque intégrateur les reconstruire autour d'identifiants isolés.
Pourquoi GraphQL convient à ce modèle
L'API Business Data Repository s'appuie sur GraphQL, bien adapté à la modélisation de données connectées.
Les intégrateurs demandent exactement les champs et les objets liés dont une interface a besoin, au lieu de récupérer des réponses complètes depuis plusieurs points d'accès figés, puis de les recoudre ensuite.
Pour les produits interactifs — consoles d'exploitation, portails clients, outils internes, interfaces d'administration —, cela signifie généralement moins de charge de transport et une logique applicative plus propre.
Ce qu'il faut en retenir
Les systèmes télématiques s'inscrivent dans une activité plus large. Les véhicules sont attelés à des remorques. Les équipements appartiennent à des sites. Les actifs sont rattachés à des contrats et à des structures clients. Ces relations sont propres à chaque entreprise.
L'API Business Data Repository est développée pour rendre ce contexte métier modélisable : définissez les structures dont vous avez besoin, reliez-les, validez-les et suivez leur évolution.
Pour les intégrateurs, le bénéfice concret est simple : moins de temps passé à lutter contre le schéma imposé d'un fournisseur, et plus de liberté pour modéliser la façon dont le client conduit réellement son activité.
Si vous voulez suivre l'évolution de ce modèle avant sa sortie, commencez par l'index de la documentation de l'API Business Data Repository et surveillez les mises à jour des guides de préversion, notamment le comportement de filtrage et de tri des champs personnalisés dans la référence sur le filtrage des champs personnalisés.
Sur cette page
- Le modèle des opérations connectées
- Partez des objets métier, pas seulement des objets par défaut de la plateforme
- Reliez les enregistrements au lieu de stocker des identifiants en texte brut
- Ajoutez les attributs correspondant au rôle de chaque objet
- Utilisez les catalogues pour garder un vocabulaire métier cohérent
- Conservez le contexte des changements, pas seulement l'état actuel
- Gérez les opérations télématiques courantes avec moins de code de liaison
- Pourquoi GraphQL convient à ce modèle
- Ce qu'il faut en retenir