Como desenvolvemos a análise conversacional de frotas com agentes de IA

AutorAndrew M., VP of Data and Solutions
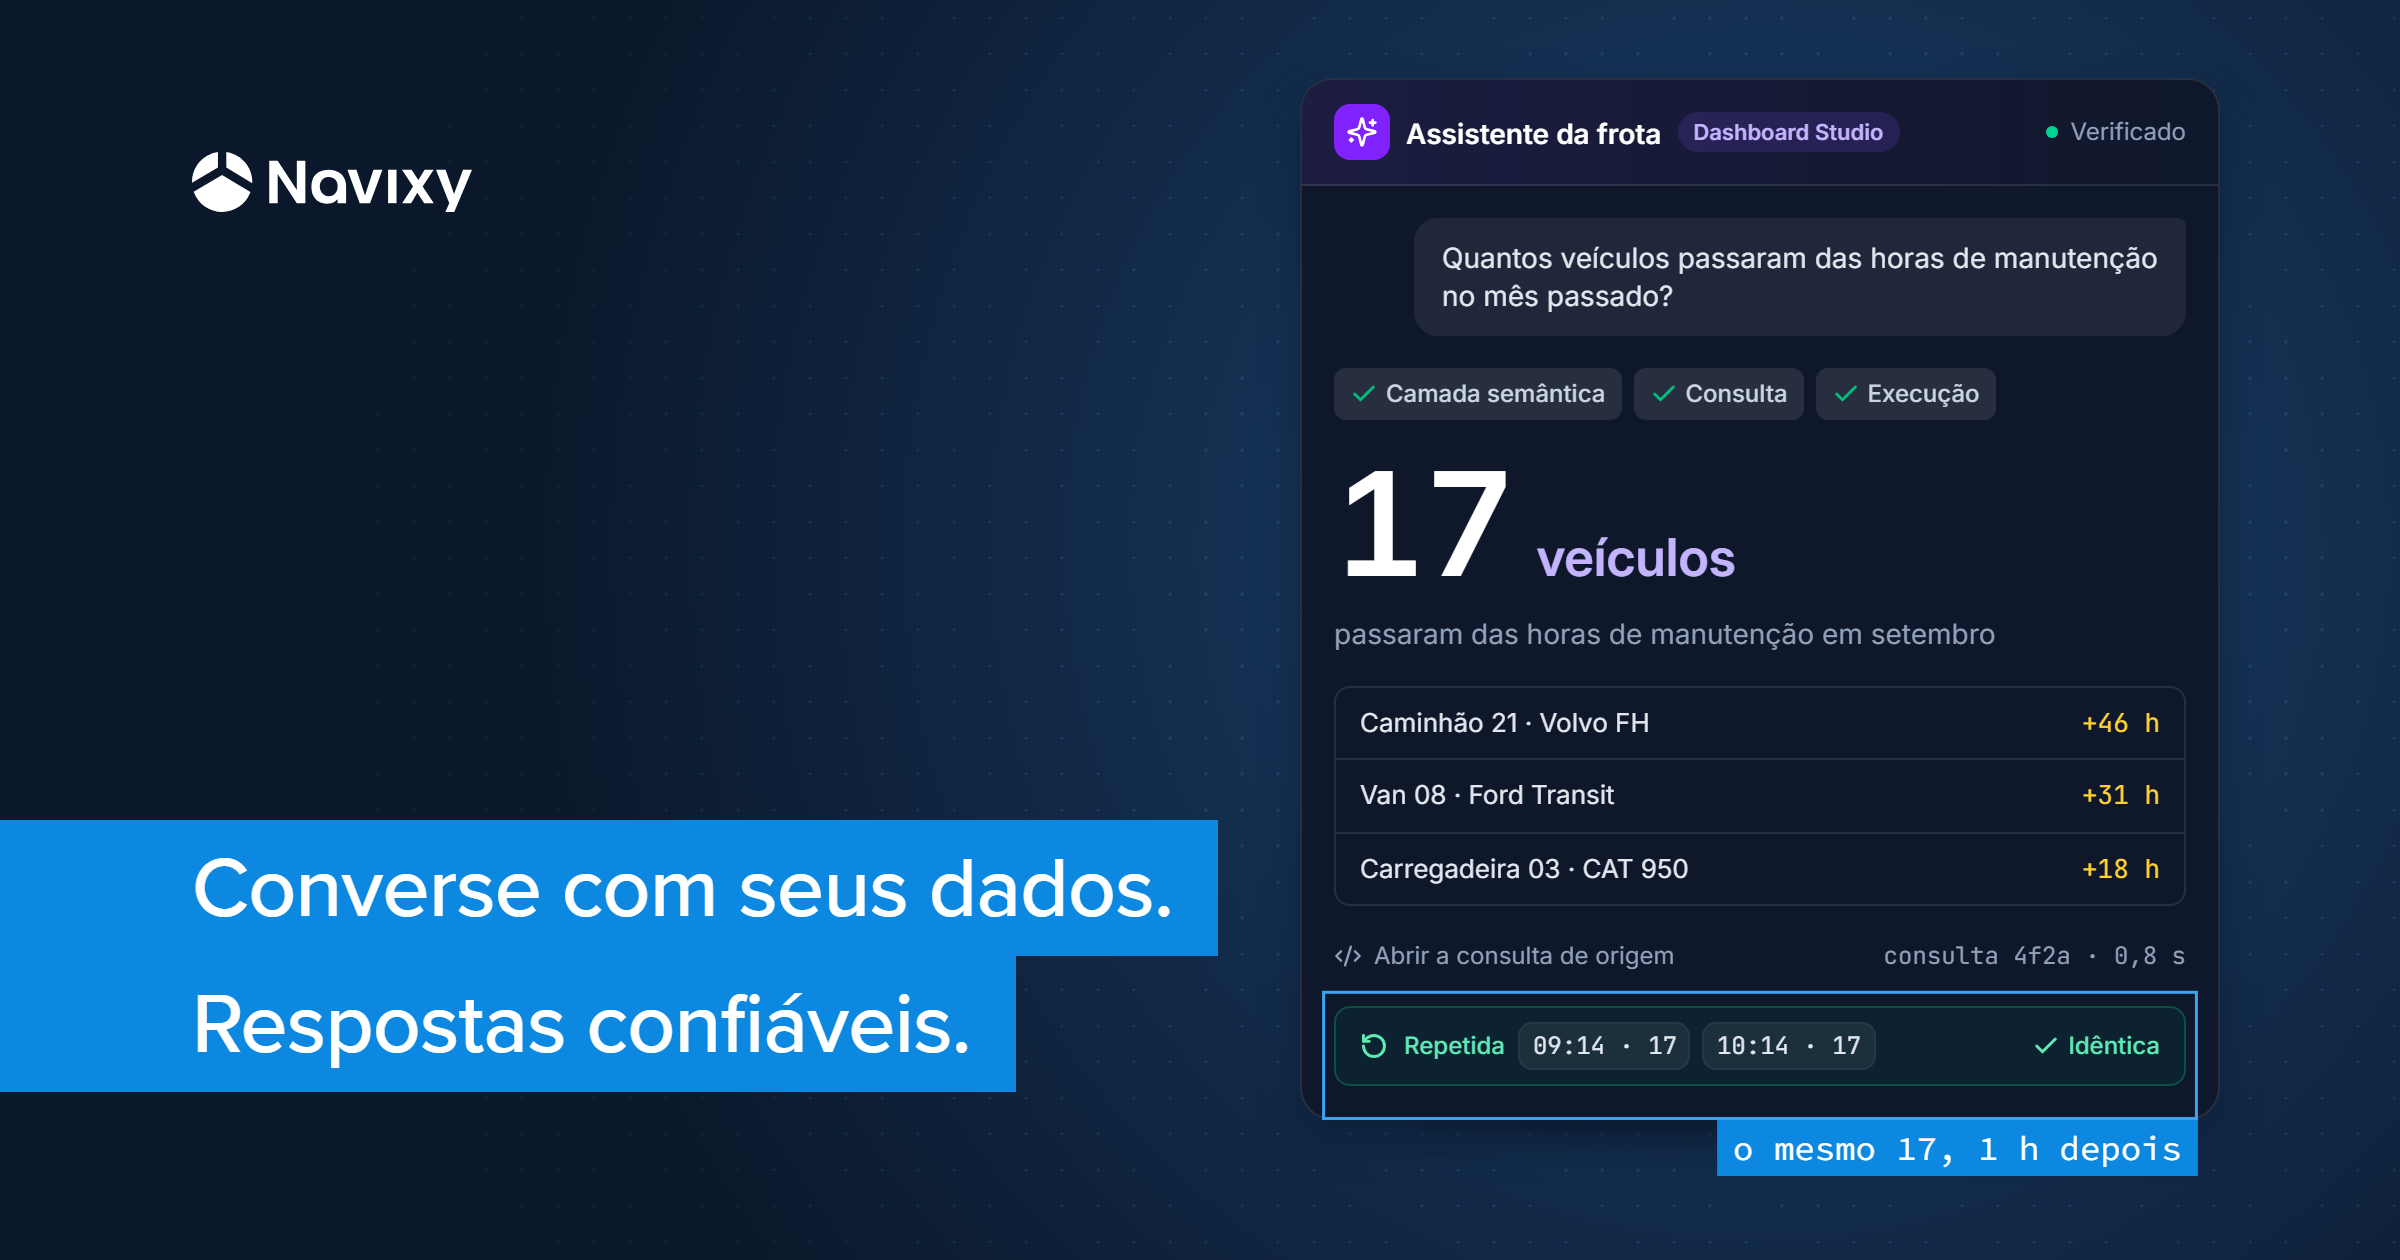
A análise conversacional é o próximo passo além dos dashboards para compreender como uma frota realmente opera — e sejamos honestos, a maioria dos dashboards nunca é estudada em profundidade. Com um agente de IA integrado ao seu sistema de análise, um usuário pode fazer uma pergunta com palavras simples, obter a informação que precisa imediatamente e aprofundar nos detalhes por conta própria.
A Navixy avança nessa direção. O agente de IA integrado à nossa ferramenta de BI Dashboard Studio já constrói dashboards a partir de solicitações em linguagem natural. Mas um assistente de texto baseado em um modelo de linguagem grande (LLM) nem sempre é preciso, então nosso objetivo principal é garantir que cada resposta seja correta e atualizada.
A confiabilidade da análise conversacional é antes de tudo um problema de arquitetura, não de chatbot. Continuamos melhorando nosso agente e queremos compartilhar como fazemos isso.
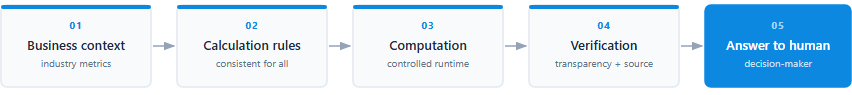
Na Navixy, nossa abordagem para a análise conversacional baseia-se em cinco camadas, cada uma eliminando uma causa específica de erros nas respostas da IA:
1. Contexto: ensinar ao fleet AI o vocabulário de telemetria
Os modelos de linguagem entendem a linguagem natural. Mas eles não sabem como um determinado termo é definido na sua plataforma ou nos processos de negócio de um cliente — e o custo dessa lacuna é mensurável. Pesquisas do setor mostram consistentemente que rotear consultas por meio de uma camada semântica de métricas predefinida reduz as taxas de erro do agente em até dois terços. Essa camada preenche a lacuna entre a linguagem universal e o contexto próprio de cada empresa.
O objetivo não é "conectar o LLM a um banco de dados de telemetria". É ensinar ao sistema o que esses dados significam para cada cliente específico.
O monitoramento de frotas está repleto de termos que apenas parecem inequívocos. Alguns exemplos:
- O que "online" significa: o rastreador enviou alguma mensagem na última hora, ou reportou uma posição GPS válida?
- O "tempo de marcha lenta" conta um período em que o motor está ligado mas a velocidade é zero? E qual limite deve ser ultrapassado?
- Uma "viagem" é definida pelo acionamento e desligamento da ignição, ou pelo movimento real? Consulte o artigo de Documentação sobre como configurar e ajustar os parâmetros de viagem dentro da plataforma.
Quando duas equipes usam a mesma palavra para dois cálculos diferentes, o sistema pode produzir com confiança uma resposta errada. Em uma solução multicliente, as definições também diferem de um cliente para outro.
2. Execução: deixar um ambiente controlado fazer os cálculos
Os modelos de IA são excelentes em gerar texto. Mas não são motores de cálculo deterministas. Faça a mesma pergunta sobre uma métrica numérica duas vezes e pode obter duas respostas diferentes. Isso se torna um problema quando essas métricas — quilometragem, horas de motor ou consumo de combustível — são as que os clientes usam em relatórios, comparações ou faturamento.
Portanto, não peça ao modelo de IA que "calcule" algo. É melhor começar pedindo que formule a lógica de cálculo e obtenha a confirmação do usuário, e depois deixar que o cálculo real seja executado por um algoritmo ou script em um ambiente de execução controlado. É aí que a qualidade dessas operações é substancialmente maior.
Um esquema confiável se parece com isso:
Entender → Planejar → Gerar consulta/código → Executar → Inspecionar → Explicar.
Executar código também torna a resposta transparente e reproduzível. A equipe técnica pode revisar o código por trás de uma resposta, verificá-lo e reproduzir o resultado — em vez de simplesmente aceitar a palavra do modelo.
3. Validação: começar estreito, expandir devagar
Os assistentes de IA lidam bem com perguntas específicas. Mas abra a porta para "pergunte qualquer coisa", e as respostas tendem a ser inaplicáveis em vez de úteis.
Pegue a análise de frotas no Dashboard Studio e compare duas consultas.
| «Quantos dispositivos estavam online ontem?» | «O que está errado com a frota?» |
|---|---|
| ✓ regras claras ✓ resposta verificável ✓ comparável com os dados da plataforma |
✗ sem regras definidas ✗ o sistema cria sua própria interpretação ✗ a resposta é difícil de verificar |
Uma abordagem mais confiável é começar com cenários específicos, avaliados contra exemplos de referência, que os clientes perguntam com mais frequência. Ao avaliar os resultados de um agente de IA, quatro critérios devem ser satisfeitos simultaneamente:
- Precisão: a resposta está correta?
- Reprodutibilidade: ela se mantém ao repetir?
- Fundamentação: ela remonta a dados reais?
- Aderência ao escopo: o sistema ficou dentro do que pode responder de forma confiável?
Na Navixy, expandimos o escopo somente quando o sistema atende os quatro critérios. Expandimos as capacidades do sistema de análise gradualmente — nunca à frente da confiança construída ao redor dele.
4. Transparência: mostrar como a resposta foi obtida
Uma resposta correta e uma resposta confiável são dois problemas diferentes. A transparência fecha a lacuna entre ambos e mantém sua equipe de suporte fora de cada chamado de "por que o número diz isso?".
Um teste simples: um usuário não técnico — um despachante ou gerente de operações, não um engenheiro — consegue entender de onde vem o valor de uma métrica em 20 a 30 segundos? Se não, o problema de confiança ainda não está resolvido. Todos que trabalham com um sistema de análise conversacional deveriam conseguir ver, com rapidez suficiente, como e em quais dados uma resposta se baseia.
Quando as pessoas veem regularmente a lógica por trás dos cálculos, constroem um modelo mental melhor do que o sistema pode e não pode fazer, e começam a fazer perguntas mais precisas. Isso cria um ciclo de feedback contínuo.
No final, a transparência se torna parte do produto. Ela também é necessária para a governança de IA e responsabilidade — perguntas que os clientes empresariais sempre farão.
5. Governança: adaptar a autonomia ao custo de errar
Um assistente de IA responde cada pergunta com a mesma confiança, mas o custo de errar não é o mesmo para cada pergunta. Quanto mais estrito o controle precisa ser, maior o custo de um erro.
- Baixo risco — resumos, comparações, exploração aberta de viagens e utilização. Essas tarefas podem rodar em grande parte no piloto automático. Um número ligeiramente errado se corrige na próxima pergunta.
- Risco médio — recomendações, interpretação de anomalias (uma queda incomum de combustível ou um desvio de rota), decisões operacionais. Essas merecem mais escrutínio, porque alguém vai agir sobre o resultado.
- Alto risco — segurança, conformidade, exposição financeira, manutenção crítica. Proteções reais são necessárias aqui. Uma resposta errada não é um inconveniente, é um incidente. A IA nunca deve adivinhar: qualquer incerteza deve imediatamente encaminhar a pergunta a um especialista humano.
Um bom padrão é a divisão de Pareto: para aproximadamente 80% das tarefas rotineiras, os usuários podem revisar o resultado por si mesmos, enquanto os 20% de decisões de alto risco requerem controles mais rígidos.
Análise conversacional em que você pode confiar
A equipe Navixy está construindo a arquitetura de seu sistema de análise conversacional não em torno de um diálogo refinado — mas em torno da confiança. Primeiro, o sistema recebe o contexto de negócios. Depois o traduz em regras de cálculo verificadas que regem cada computação. As computações são executadas de forma controlada e transparente. Cada resultado é verificado e imediatamente exibido com os dados em que se baseia. Somente então a resposta chega ao humano que toma a decisão.
A experiência de "conversar com seus dados" que os usuários percebem é apenas a superfície. A vantagem real surge quando o sistema pode não apenas responder, mas explicar, verificar seus dados e trazer um humano onde atenção é necessária. É isso que os clientes continuam usando — porque os ajuda a tomar decisões com confiança.
Pronto para colocar essas cinco camadas em prática? Fale conosco sobre como construir soluções de IA para frotas nas quais seus clientes possam confiar.
Nesta página
- 1. Contexto: ensinar ao fleet AI o vocabulário de telemetria
- 2. Execução: deixar um ambiente controlado fazer os cálculos
- 3. Validação: começar estreito, expandir devagar
- 4. Transparência: mostrar como a resposta foi obtida
- 5. Governança: adaptar a autonomia ao custo de errar
- Análise conversacional em que você pode confiar