Как мы строим разговорную аналитику автопарка на основе ИИ-агентов

АвторAndrew M., VP of Data and Solutions
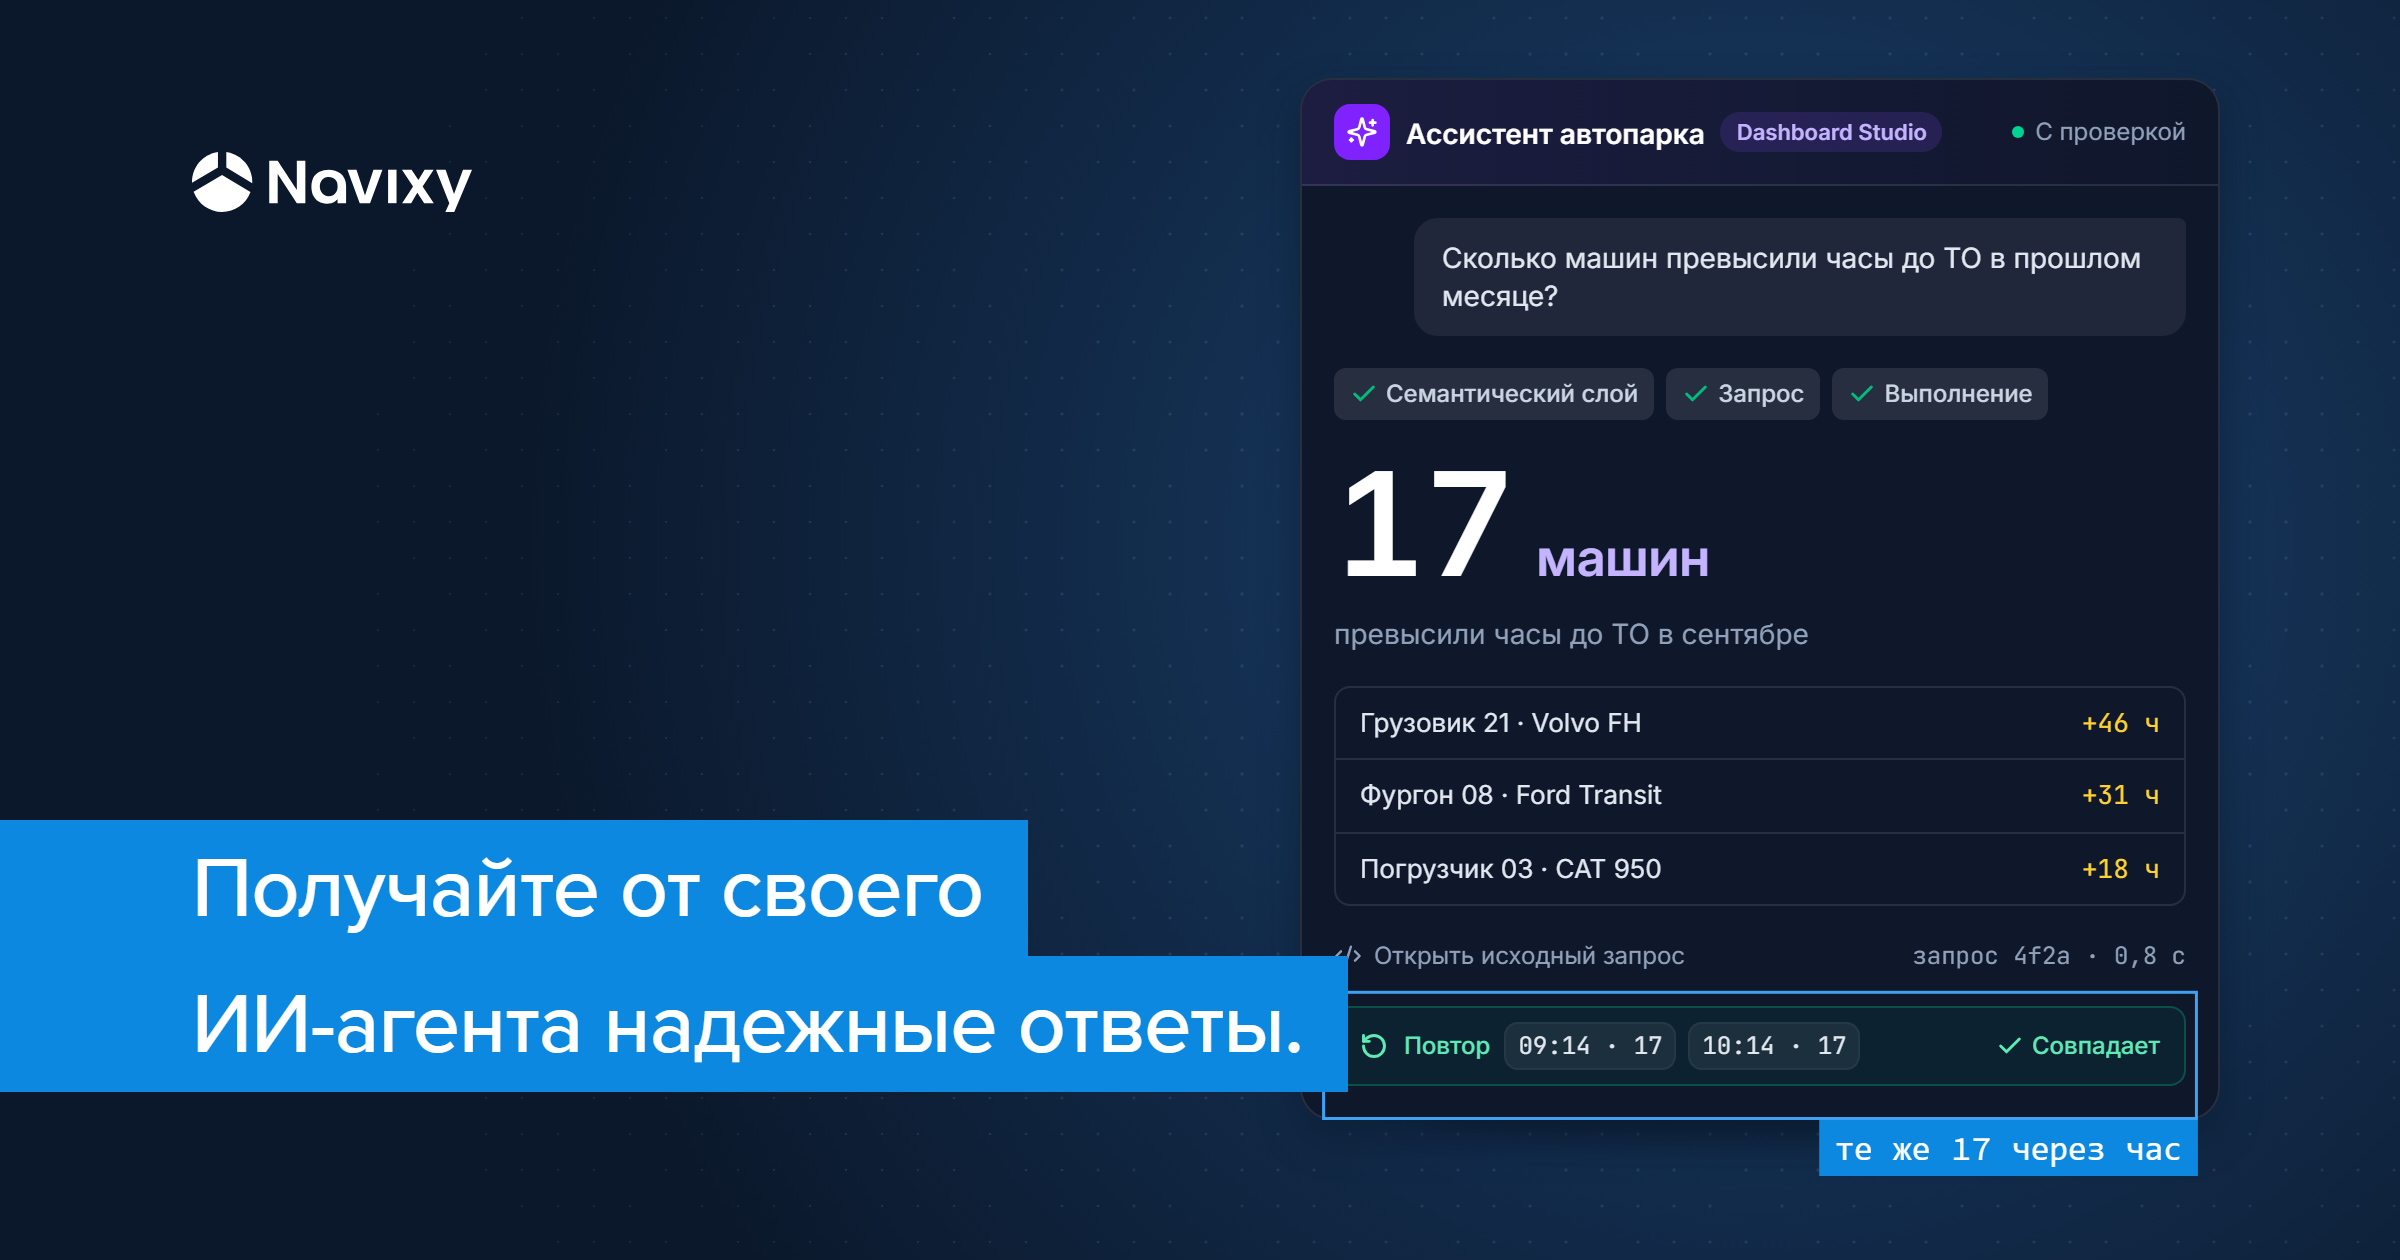
Разговорная аналитика — следующий шаг к пониманию того, как работает автопарк, после дашбордов. Давайте признаем, их редко изучают досконально. Внедрив ИИ-агента в свою аналитическую систему, пользователь может задать ему вопрос обычными словами, тут же получить интересующую информацию и самостоятельно углубиться в детали.
Navixy также движется в этом направлении. Встроенный в BI-инструмент Dashboard Studio ИИ-агент уже позволяет создавать дашборды по запросу на естественном языке. Однако текстовый ассистент на базе большой языковой модели (LLM) не всегда может быть точен, поэтому главная задача — обеспечить правильность и актуальность ответов.
Надежность разговорной аналитики — это прежде всего вопрос архитектуры, а не чат-бота. Мы продолжаем совершенствовать нашего агента и хотим поделиться опытом, как мы это делаем.
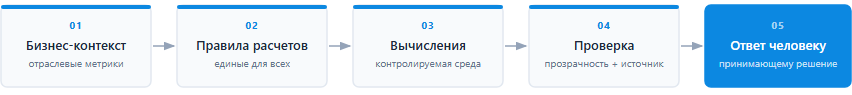
В Navixy подход к разговорной аналитике базируется на пяти уровнях, каждый из которых устраняет определенную причину ошибок в ответах ИИ:
1. Контекст: обучаем ИИ терминологии вашего автопарка
Языковые модели понимают естественный язык. Но они не знают, как тот или иной термин определен в вашей платформе или в бизнес-процессах клиента. И последствия этого разрыва можно измерить. Отраслевые исследования последовательно показывают: маршрутизация запросов через заранее определенный семантический слой метрик снижает частоту ошибок агента до двух третей. Эта «прокладка» устраняет разрыв между универсальным языком и контекстом конкретной компании.
Задача состоит не в том, чтобы «подключить LLM к базе телеметрии». Важно научить систему понимать, что означают эти данные для каждого конкретного клиента.
В мониторинге автопарка много терминов, которые лишь кажутся однозначными. Приведем лишь несколько примеров:
- Что означает «на связи»: трекер передал любое сообщение за последний час или отправил корректные данные о местоположении по GPS?
- Считается ли «временем простоя» период, когда двигатель работает, а скорость равна нулю? И какое пороговое значение при этом должно быть превышено?
- «Поездка» определяется по включению и выключению зажигания или по фактическому движению? Как задать и изменить параметры поездки внутри платформы, читайте в статье в Документации.
Если две команды используют один и тот же термин для разных расчетов, система может уверенно выдать неверный ответ. А в решении, которым пользуются несколько клиентов, определения могут отличаться и от клиента к клиенту.
2. Выполнение: доверяем расчеты контролируемой среде
ИИ-модели отлично генерируют текст. Но они не являются детерминированными вычислительными системами. Задайте один и тот же вопрос о числовом показателе дважды, и можете получить два разных ответа. Это может быть проблемой, когда речь идет о таких показателях, которые могут трактоваться моделью по-разному: пробег, моточасы или расход топлива. Именно эти показатели клиенты используют в отчетности, сравнивают или берут за основу при выставлении счетов.
Поэтому не стоит просить ИИ-модель «посчитать» что-то. Корректнее начать с просьбы сформулировать логику расчета с дальнейшим подтверждением пользователя. При этом сами вычисления выполняет алгоритм или скрипт в контролируемой среде выполнения. Тогда качество подобных операций будет заметно выше.
Надежная схема выглядит так:
Понять → Составить план → Сформировать запрос или код → Выполнить → Проверить → Объяснить.
Выполнение кода также делает ответ прозрачным и воспроизводимым. Техническая команда может посмотреть код, на основе которого получен ответ, проверить и воспроизвести результат, а не просто принять утверждение модели на веру.
3. Проверка: начинаем с узкого круга задач и постепенно его расширяем
ИИ-ассистенты хорошо справляются с конкретными вопросами. Но если предложить пользователю «спросить о чем угодно», ответы чаще оказываются неприменимыми.
Возьмем аналитику автопарка в Dashboard Studio и сравним два запроса.
| «Сколько маячков было на связи вчера?» | «Что не так с автопарком?» |
|---|---|
| ✓ четкие правила ✓ проверяемый ответ ✓ можно сопоставить с данными самой платформы |
✗ правила не установлены ✗ система создает самостоятельную интерпретацию запроса ✗ проверить ответ проблематично |
Более надежный подход — начать с конкретных сценариев, проверенных на эталонных примерах, наиболее востребованных клиентами. Оценивая результаты, полученные от ИИ-агента, необходимо одновременно учитывать четыре критерия:
- Точность: верен ли ответ?
- Воспроизводимость: сохраняется ли результат при повторном запросе?
- Опора на исходные данные: можно ли проследить, на каких реальных данных основан ответ?
- Соблюдение границ возможностей: не вышла ли система за пределы задач, которые умеет надежно решать?
В Navixy мы дополняем круг задач только тогда, когда система соответствует всем четырем критериям. Возможности аналитической системы расширяем постепенно — никогда не опережая рост доверия к ней.
4. Прозрачность: показываем, как получен ответ
Правильный ответ и доверие к этому ответу — две разные задачи. Прозрачность помогает устранить разрыв между ними и избавляет команду поддержки от необходимости разбирать каждое обращение в духе «почему здесь такое число?».
Простой критерий: может ли обычный пользователь (диспетчер или руководитель, а не инженер) за 20–30 секунд понять, как получилось значение показателя? Если нет — проблема доверия еще не решена. У каждого, кто работает с системой разговорной аналитики, должна быть возможность достаточно быстро понять, как и на каких данных основан ответ.
Когда сотрудники регулярно видят логику расчетов, они лучше понимают, на что система способна, а на что — нет, и начинают задавать более точные вопросы. Так формируется постоянная обратная связь.
В итоге прозрачность становится частью продукта. Кроме того, она нужна для управления ИИ и подотчетности — вопросов, которые корпоративные клиенты обязательно зададут.
5. Управление рисками: соотносим самостоятельность ИИ с ценой ошибки
ИИ-ассистент может отвечать на все вопросы с одинаковой уверенностью, но последствия ошибки далеко не всегда одинаковы. Чем выше цена ошибки, тем строже должен быть контроль.
- Низкий риск — сводки, сравнения, свободный анализ поездок и использования техники. Такие задачи в значительной степени можно выполнять автоматически. Небольшая неточность может быть исправлена следующим вопросом.
- Средний риск — рекомендации, интерпретация аномалий, например необычного снижения уровня топлива или отклонения от маршрута, а также операционные решения. Здесь требуется более тщательная проверка, потому что на основе результата кто-то будет действовать.
- Высокий риск — безопасность, соблюдение нормативных требований, финансовые риски, критически важное техническое обслуживание. Здесь необходимы строгие ограничения и защитные механизмы. Ошибка — уже не неудобство, а инцидент. ИИ не должен гадать: при любой неопределенности вопрос необходимо сразу передавать профильному специалисту.
Разумный ориентир — принцип Парето: примерно в 80% рутинных задач пользователи могут сами проверить результат, тогда как 20% решений с серьезными последствиями требуют более строгого контроля.
Разговорная аналитика, которой можно доверять
Команда Navixy создает архитектуру системы разговорной аналитики не вокруг красивого диалога, а вокруг доверия! Сначала система получает бизнес-контекст. Затем переводит его в проверенные правила, по которым дальше идут все расчеты. Вычисления выполняются контролируемо по четкой и понятной логике. Каждый результат проверяется и сразу сопровождается данными, на которых он основан. Только после этого ответ попадает к принимающему решения человеку.
«Диалог с данными», который пользователи замечают, — это лишь то, что находится на поверхности. Настоящее преимущество появляется, когда система умеет не просто отвечать, а объяснять, проверять данные и привлекать человека там, где требуется его внимание. Такие аналитические системы клиенты продолжают использовать — потому что они помогают принимать решения с уверенностью.
Готовы применить эти пять уровней на практике? Свяжитесь с нами, чтобы обсудить создание ИИ-решений для автопарков, которым смогут доверять ваши клиенты.
На этой странице
- 1. Контекст: обучаем ИИ терминологии вашего автопарка
- 2. Выполнение: доверяем расчеты контролируемой среде
- 3. Проверка: начинаем с узкого круга задач и постепенно его расширяем
- 4. Прозрачность: показываем, как получен ответ
- 5. Управление рисками: соотносим самостоятельность ИИ с ценой ошибки
- Разговорная аналитика, которой можно доверять