Cómo construimos la analítica conversacional de flotas con agentes de IA

AutorAndrew M., VP of Data and Solutions
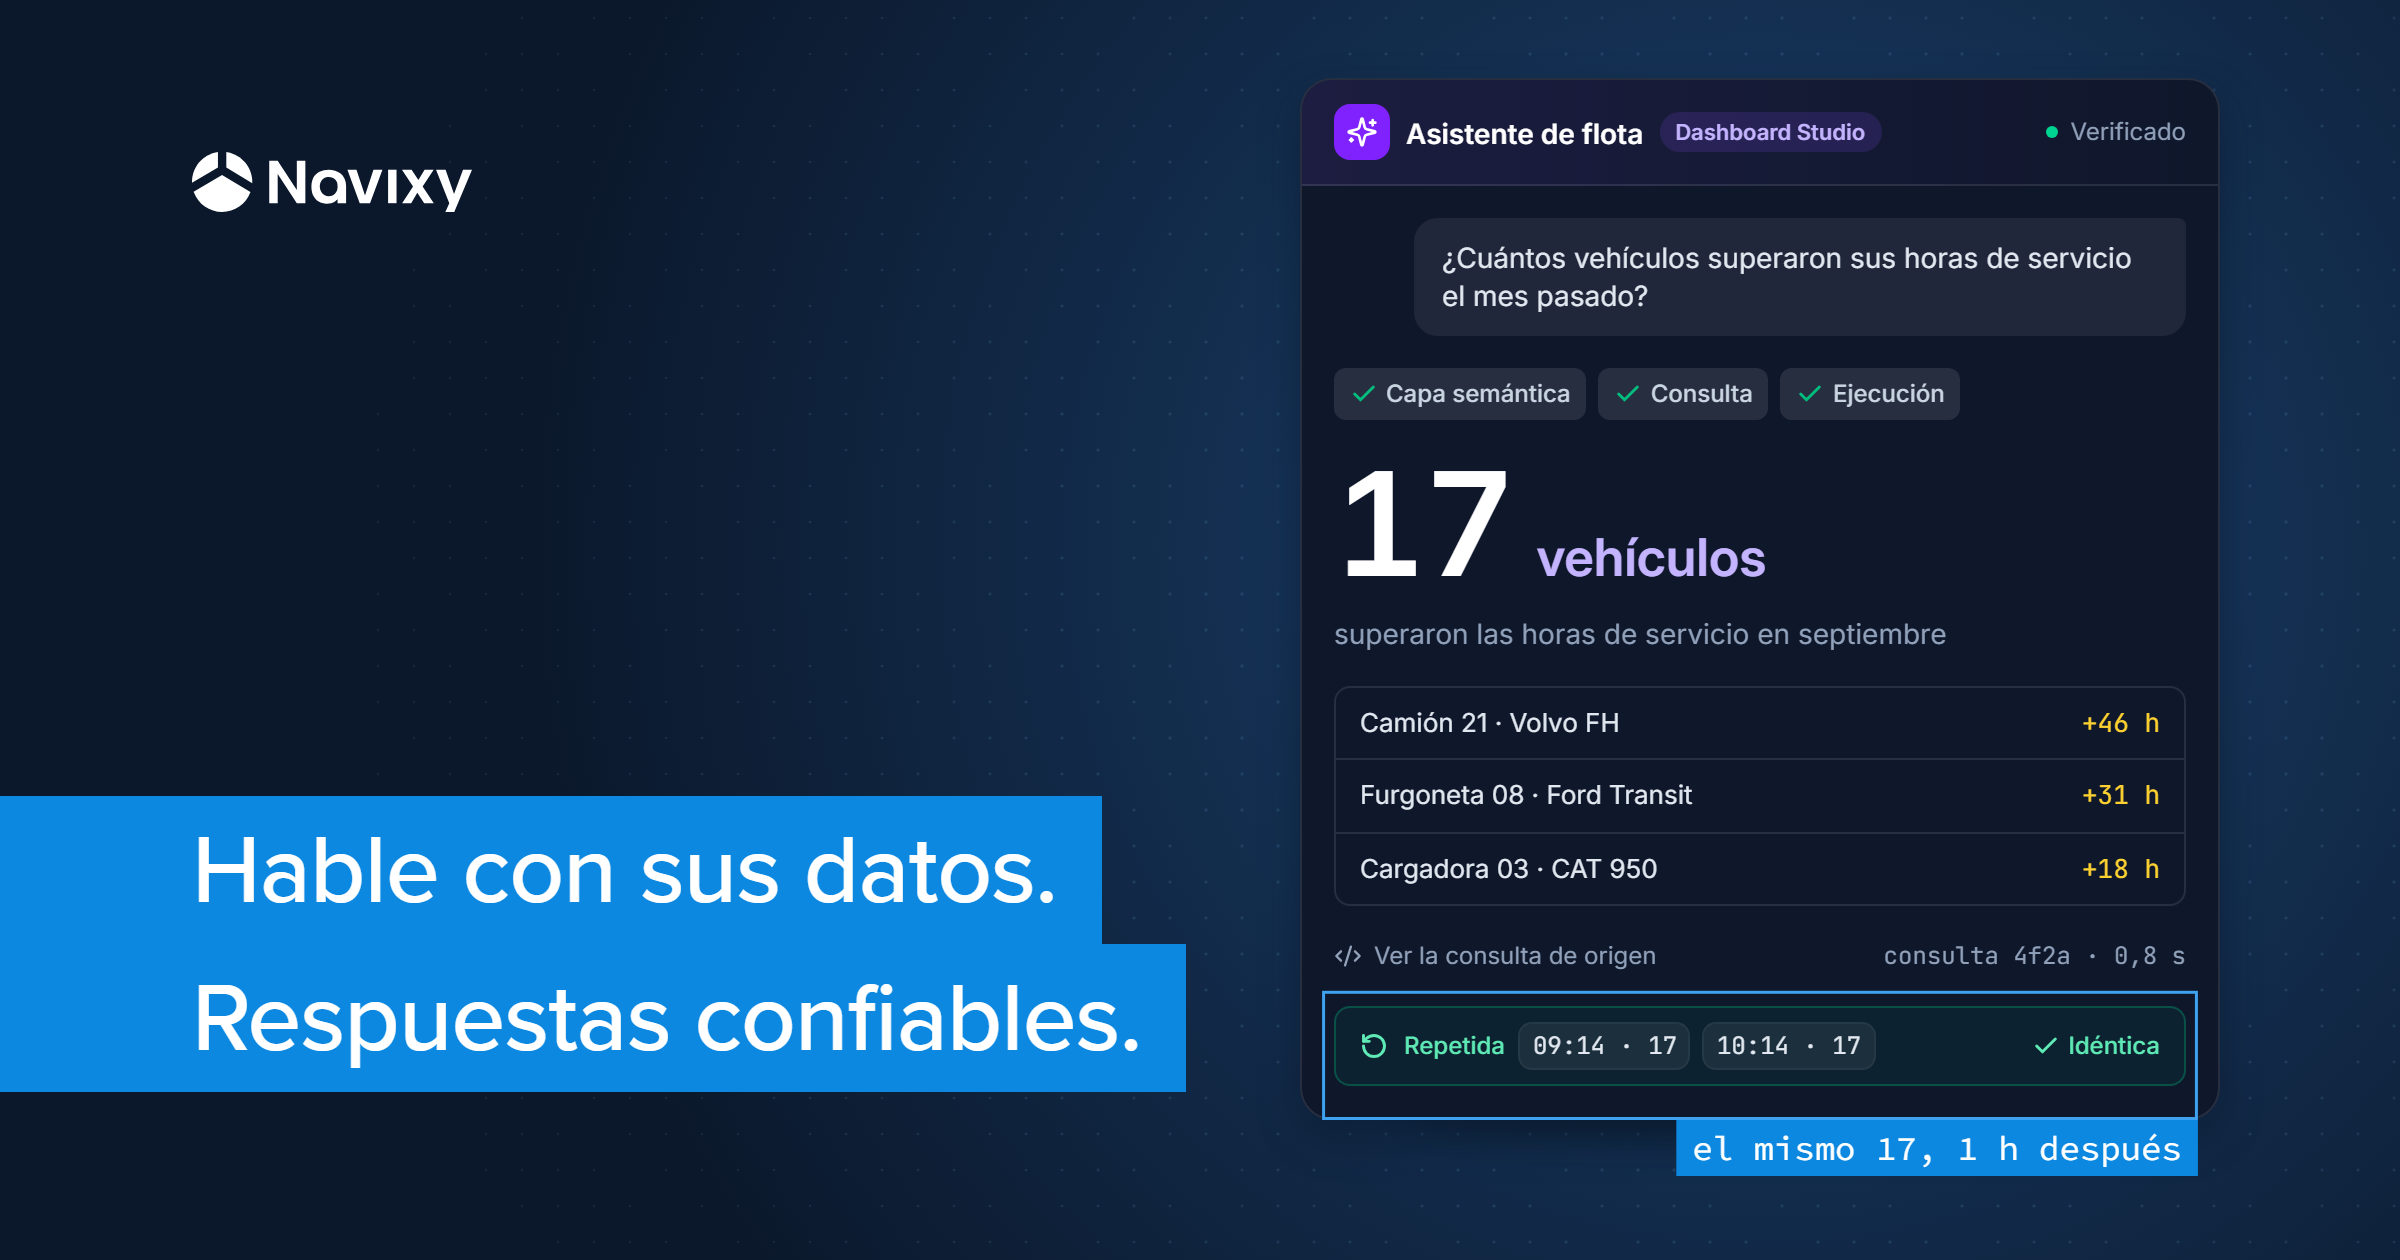
La analítica conversacional es el siguiente paso más allá de los dashboards para comprender cómo opera realmente una flota — y seamos honestos, la mayoría de los dashboards nunca se estudian en profundidad. Con un agente de IA integrado en su sistema de analítica, un usuario puede hacer una pregunta con palabras simples, obtener la información que necesita de inmediato y profundizar en los detalles por su cuenta.
Navixy avanza en esta dirección. El agente de IA integrado en nuestra herramienta de BI Dashboard Studio ya construye dashboards a partir de solicitudes en lenguaje natural. Pero un asistente de texto basado en un modelo de lenguaje grande (LLM) no siempre es preciso, así que nuestro objetivo principal es garantizar que cada respuesta sea correcta y esté actualizada.
La confiabilidad de la analítica conversacional es ante todo un problema de arquitectura, no de chatbot. Seguimos mejorando nuestro agente y queremos compartir cómo lo hacemos.
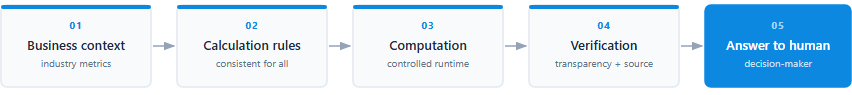
En Navixy, nuestro enfoque para la analítica conversacional se basa en cinco capas, cada una de las cuales elimina una causa específica de errores en las respuestas de la IA:
1. Contexto: enseña al fleet AI el vocabulario de telemática
Los modelos de lenguaje entienden el lenguaje natural. Pero no saben cómo se define un término en su plataforma ni en los procesos de negocio de un cliente — y el costo de esa brecha se puede medir. La investigación del sector muestra de forma consistente que enrutar las consultas a través de una capa semántica de métricas predefinida reduce las tasas de error del agente hasta en dos tercios. Esa capa cierra la brecha entre el lenguaje universal y el contexto de cada empresa.
El objetivo no es "conectar el LLM a una base de datos de telemetría". Es enseñar al sistema qué significan estos datos para cada cliente específico.
El monitoreo de flotas está lleno de términos que solo parecen inequívocos. Algunos ejemplos:
- Qué significa "en línea": ¿el rastreador envió algún mensaje en la última hora, o reportó una posición GPS válida?
- ¿El "tiempo en ralentí" cuenta un período cuando el motor está encendido pero la velocidad es cero? ¿Y qué umbral debe superarse?
- ¿Un "viaje" se define por el encendido y apagado del motor, o por el movimiento real? Consulte el artículo de Documentación sobre cómo configurar y ajustar los parámetros de viaje dentro de la plataforma.
Cuando dos equipos usan la misma palabra para dos cálculos distintos, el sistema puede generar una respuesta incorrecta con total confianza. En una solución multicliente, las definiciones también difieren de un cliente a otro.
2. Ejecución: deja que un entorno controlado haga los cálculos
Los modelos de IA son excelentes para generar texto. Pero no son motores de cálculo deterministas. Haga la misma pregunta sobre una métrica numérica dos veces y puede obtener dos respuestas distintas. Esto se convierte en un problema cuando esas métricas — kilometraje, horas de motor o consumo de combustible — son las que los clientes usan en informes, comparaciones o facturación.
Por eso, no le pida al modelo de IA que "calcule" algo. Es mejor empezar pidiéndole que formule la lógica de cálculo y obtenga la confirmación del usuario, y luego hacer que el cómputo real lo ejecute un algoritmo o script en un entorno de ejecución controlado. Ahí la calidad de esas operaciones es sustancialmente mayor.
Un esquema confiable se ve así:
Entender → Planear → Generar consulta/código → Ejecutar → Inspeccionar → Explicar.
Ejecutar código también hace que la respuesta sea transparente y reproducible. El equipo técnico puede revisar el código detrás de una respuesta, verificarlo y reproducir el resultado — en lugar de solo aceptar la palabra del modelo.
3. Validación: empieza acotado y amplía despacio
Los asistentes de IA manejan bien las preguntas específicas. Pero abre la puerta al "pregunta lo que quieras", y las respuestas tienden a ser inaplicables en lugar de útiles.
Toma la analítica de flotas en Dashboard Studio y compara dos consultas.
| «¿Cuántos dispositivos estaban en línea ayer?» | «¿Qué le pasa a la flota?» |
|---|---|
| ✓ reglas claras ✓ respuesta verificable ✓ comparable con los datos de la plataforma |
✗ sin reglas definidas ✗ el sistema crea su propia interpretación ✗ la respuesta es difícil de verificar |
Un enfoque más confiable es comenzar con escenarios específicos, evaluados contra ejemplos de referencia, que los clientes preguntan con más frecuencia. Al evaluar los resultados de un agente de IA, cuatro criterios deben cumplirse simultáneamente:
- Exactitud: ¿la respuesta es correcta?
- Reproducibilidad: ¿se mantiene al repetirla?
- Fundamentación: ¿se remonta a datos reales?
- Adhesión al alcance: ¿el sistema se quedó dentro de lo que puede responder de forma confiable?
En Navixy, ampliamos el alcance solo cuando el sistema cumple los cuatro. Hacemos crecer las capacidades del sistema de analítica gradualmente — nunca por delante de la confianza construida a su alrededor.
4. Transparencia: muestra cómo se llegó a la respuesta
Una respuesta correcta y una respuesta confiable son dos problemas distintos. La transparencia cierra la brecha entre ambos y mantiene al equipo de soporte fuera de cada ticket de "¿por qué dice ese número?".
Una prueba sencilla: ¿puede un usuario no técnico — un despachador o un gerente de operaciones, no un ingeniero — entender de dónde proviene el valor de una métrica en 20 a 30 segundos? Si no, el problema de confianza no está resuelto aún. Todos los que trabajan con un sistema de analítica conversacional deberían poder ver, con suficiente rapidez, cómo y sobre qué datos se basa una respuesta.
Cuando las personas ven regularmente la lógica detrás de los cálculos, construyen un mejor modelo de lo que el sistema puede y no puede hacer, y empiezan a hacer preguntas más precisas. Eso crea un ciclo de retroalimentación continuo.
Al final, la transparencia se convierte en parte del producto. También es necesaria para la gobernanza de la IA y la rendición de cuentas — preguntas que los clientes empresariales siempre van a hacer.
5. Gobernanza: ajusta la autonomía al costo de equivocarse
Un asistente de IA responde cada pregunta con la misma confianza, pero el costo de equivocarse no es el mismo para cada pregunta. Cuanto más estricto debe ser el control, mayor es el costo de un error.
- Riesgo bajo — resúmenes, comparaciones, exploración abierta de viajes y utilización. Estas tareas pueden ejecutarse en gran parte en piloto automático. Un número ligeramente incorrecto se corrige en la siguiente pregunta.
- Riesgo medio — recomendaciones, interpretación de anomalías (una caída inusual de combustible o una desviación de ruta), decisiones operativas. Estas merecen más escrutinio, porque alguien va a actuar sobre el resultado.
- Riesgo alto — seguridad, cumplimiento, exposición financiera, mantenimiento crítico. Aquí se requieren salvaguardas reales. Una respuesta incorrecta no es una molestia, es un incidente. La IA nunca debe adivinar: cualquier incertidumbre debe pasar inmediatamente la pregunta a un experto humano.
Un buen valor por defecto es la distribución de Pareto: para aproximadamente el 80% de las tareas rutinarias, los usuarios pueden revisar el resultado por sí mismos, mientras que el 20% de las decisiones de alto riesgo requieren controles más estrictos.
Analítica conversacional en la que puede confiar
El equipo de Navixy está construyendo la arquitectura de su sistema de analítica conversacional no en torno a un diálogo pulido, sino en torno a la confianza. Primero, el sistema recibe el contexto de negocio. Luego lo traduce en reglas de cálculo verificadas que rigen cada cómputo. Los cómputos se ejecutan de forma controlada y transparente. Cada resultado se verifica y se muestra de inmediato con los datos en los que se basa. Solo entonces llega la respuesta al ser humano que toma la decisión.
La experiencia de "chatear con sus datos" que los usuarios notan es solo la superficie. La ventaja real aparece cuando el sistema no solo puede responder, sino explicar, verificar sus datos y traer a un humano donde se necesita atención. Eso es lo que los clientes siguen usando — porque los ayuda a tomar decisiones con confianza.
¿Listo para implementar estas cinco capas? Hable con nosotros sobre cómo construir soluciones de IA para flotas en las que sus clientes puedan confiar.
En esta página
- 1. Contexto: enseña al fleet AI el vocabulario de telemática
- 2. Ejecución: deja que un entorno controlado haga los cálculos
- 3. Validación: empieza acotado y amplía despacio
- 4. Transparencia: muestra cómo se llegó a la respuesta
- 5. Gobernanza: ajusta la autonomía al costo de equivocarse
- Analítica conversacional en la que puede confiar