Monitoreo de presencia en el hogar que distingue ausencias de fallas
AutorBenjamin Hayes
La ausencia de una señal de presencia en el hogar puede significar varias cosas: la persona pudo haber salido, la detección local pudo haber fallado o el equipo de monitoreo pudo haber dejado de enviar datos.
Para los proveedores que ofrecen servicios de monitoreo del cumplimiento del toque de queda en el hogar, estas posibilidades tienen consecuencias operativas muy distintas. Tratar cada señal ausente como una salida confirmada puede generar escalaciones innecesarias. Considerar el silencio del equipo como prueba de que la persona continúa en casa puede crear un problema mucho más grave: una interrupción del monitoreo que pasa inadvertida.
Por eso, un servicio de monitoreo útil debe hacer más que generar una alerta. Debe ayudar a los operadores a responder tres preguntas:
- ¿Qué sabemos realmente sobre la presencia de la persona?
- ¿Qué podría explicar la falta de una observación?
- ¿Quién debe investigar y qué información necesita?
Este artículo analiza cómo los TSP y los desarrolladores de soluciones pueden combinar observaciones de presencia local, telemetría del dispositivo wearable y datos sobre el estado del equipo para facilitar la interpretación de las excepciones de monitoreo. Tomando como referencia de hardware la estación doméstica S921 de Megastek y el rastreador de tobillo MT200X, examinamos qué datos necesita este tipo de servicio y cómo las capacidades de procesamiento, integración y análisis de Navixy pueden respaldarlo.
El objetivo no es que el sistema decida si se produjo una infracción del toque de queda. Se trata de reducir el tiempo y la incertidumbre que implica investigar una excepción, sin ocultar los límites de la información disponible.
¿Qué ocurre cuando se requiere presencia en el hogar, pero la detección se detiene?
Supongamos que el toque de queda comienza a las 9 p. m. El servicio de monitoreo cuenta con una observación anterior de presencia en el hogar, pero ninguna detección reciente confirma que el wearable asignado siga cerca de la estación.
Ahora un operador debe investigar la situación.
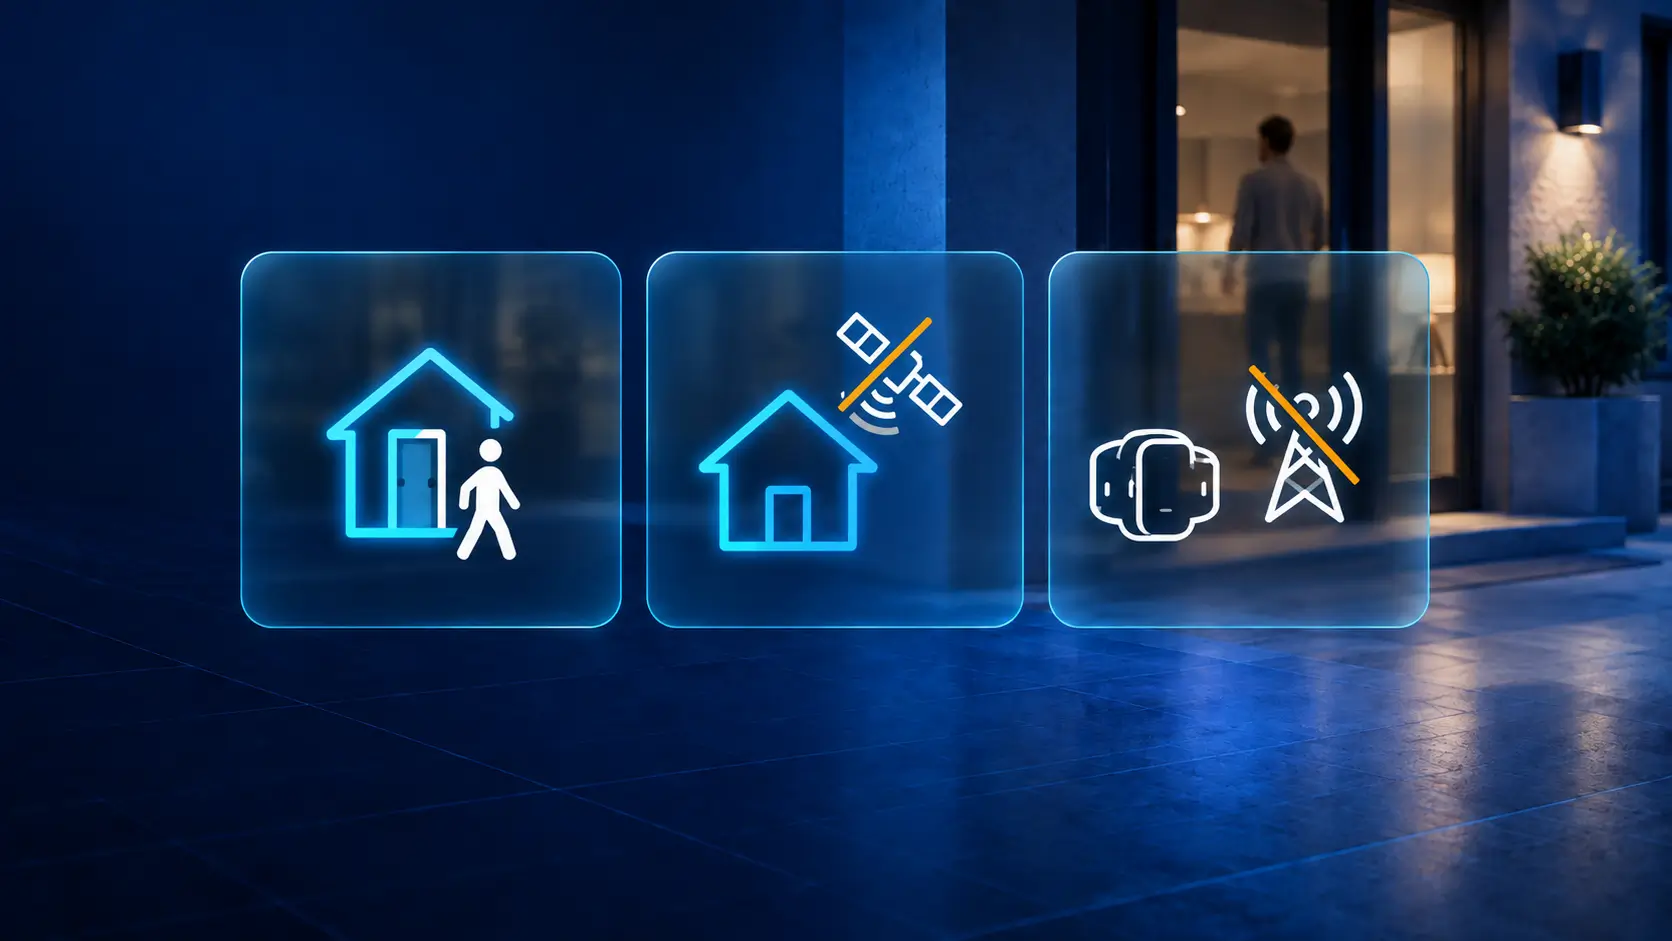
La persona pudo haber salido. La estación pudo haber perdido la conexión. El wearable pudo haber dejado de transmitir. Las condiciones locales de radio también pueden estar afectando la detección. Una posición antigua en el mapa sirve de poco para distinguir entre estas posibilidades si no se muestran claramente su antigüedad y su origen.
El tiempo dedicado a esta investigación también representa un problema operativo. Una revisión de la Oficina de Rendición de Cuentas de Estados Unidos sobre el monitoreo de ubicación identificó carencias en la información estructurada sobre las causas de las alertas y el tiempo que los agentes dedicaban a investigarlas y responder. Para un TSP, esto señala un requisito práctico del servicio: reunir las observaciones relevantes para que el operador no tenga que reconstruir manualmente lo ocurrido.
En otras palabras, el objetivo no consiste únicamente en detectar la falta de una señal de presencia. Se trata de convertirla en una imagen operativa más útil:
La presencia ya no está confirmada. Esto es lo que reporta la estación, lo que reporta el wearable, qué tan recientes son las observaciones, si existe una salida autorizada y si la situación parece una excepción de supervisión o un problema de monitoreo.
Esta distinción puede reducir escalaciones innecesarias, acortar el tiempo de investigación y ayudar a los equipos técnicos a resolver interrupciones relacionadas con el equipo sin tratarlas como incidentes de supervisión.
Qué aporta una estación doméstica al monitoreo mediante wearables
Para entender qué podría ayudar en nuestro escenario de las 9 p. m., primero debemos examinar lo que el equipo realmente puede indicar. Una estación fija y un wearable observan diferentes partes de la situación. Sus funciones determinan qué conclusiones puede sacar razonablemente el servicio.
Cómo trabajan juntos la estación doméstica y el rastreador de tobillo
Megastek S921 es una estación doméstica fija diseñada para funcionar con rastreadores de tobillo compatibles, incluido MT200X. Megastek indica una conexión Wi-Fi con el wearable y un alcance nominal de detección de 15 a 20 metros. La estación también admite alertas por desconexión de la alimentación, extracción, golpes y SOS, además de mensajes heartbeat.
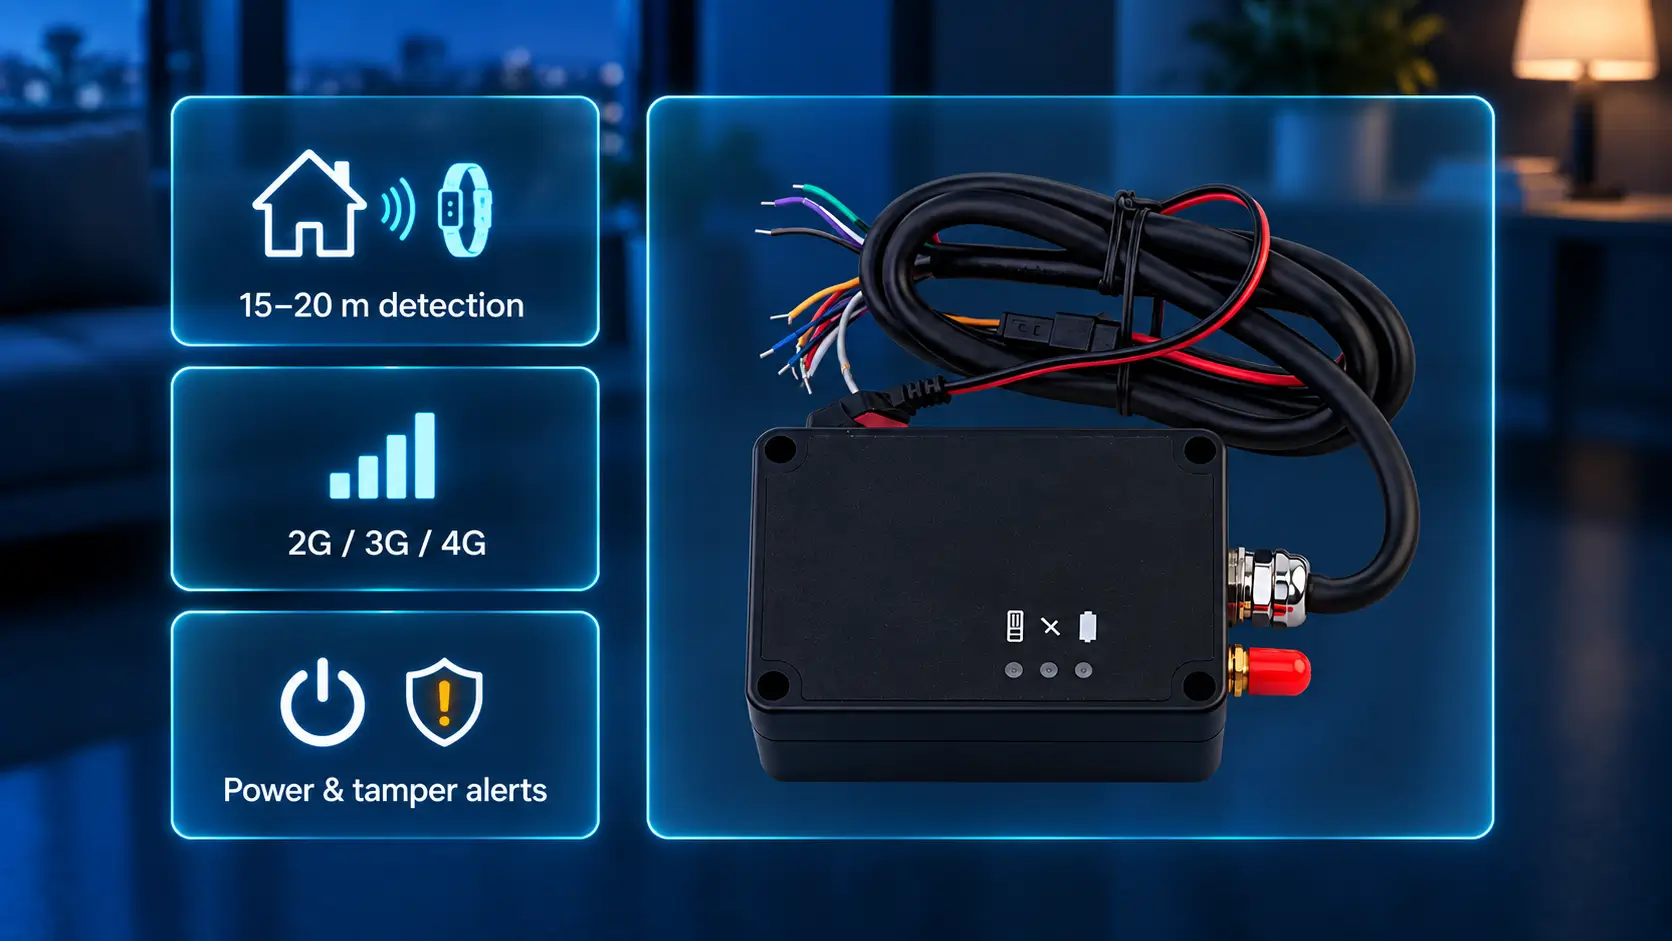
MT200X aporta posicionamiento en exteriores, así como estados y alertas relacionados con el wearable.
En conjunto, los dispositivos pueden proporcionar tres tipos de información útil:
- observaciones de presencia local procedentes de la estación;
- posicionamiento exterior procedente del wearable;
- estados y alertas del equipo que pueden ayudar a explicar una interrupción del monitoreo.
Esta combinación resulta más útil que cualquier señal aislada, pero solo si el servicio conserva el significado real de cada observación.
Qué nos indica realmente la proximidad a la estación
Una detección reciente aporta evidencia de que el wearable asignado se encontraba cerca de la estación en el momento de la observación. No establece una habitación concreta ni los límites exactos de una propiedad, y tampoco verifica por sí sola quién lleva puesto el dispositivo.
El alcance nominal también debe comprobarse durante la instalación. Las paredes, los departamentos vecinos y la ubicación de la estación pueden afectar la detección local. Estas condiciones deben considerarse al interpretar una interrupción en la detección.
El principio es sencillo:
Una observación aporta evidencia sobre una situación en un momento determinado. No constituye automáticamente una prueba de todo lo que el operador necesita saber.
Antes de interpretar una señal, hay que establecer su contexto
Antes de definir las condiciones de alerta, el desarrollador necesita un contrato de datos claro. El servicio debe saber qué observaciones están disponibles, a qué equipos pertenecen, cuándo ocurrieron y qué contexto operativo se aplica.
Qué wearable, qué estación y qué asignación
Comencemos por la propia observación.
¿Qué wearable fue detectado? ¿Qué estación intervino? ¿Cuándo ocurrió la observación? ¿Qué equipos están asignados actualmente a la instalación monitoreada?
Esta relación es importante cuando se sustituyen o reasignan dispositivos. El historial de asignaciones debe conservarse para poder interpretar los eventos anteriores según la relación entre los equipos que estaba vigente en ese momento.
Un mensaje reciente puede contener una observación antigua
La hora del evento registrada por el dispositivo y la hora de recepción en el servidor deben mantenerse separadas.
Un mensaje retrasado puede describir correctamente un evento anterior sin aportar información sobre la situación actual. Por eso, el servicio debe distinguir entre:
- el estado de la estación;
- el estado del wearable;
- la vigencia de la observación de presencia.
Un heartbeat reciente puede confirmar que existe comunicación sin aportar una nueva observación de presencia. La información sobre alimentación y conectividad puede ayudar a explicar una interrupción, siempre que el servicio conozca qué señales proporciona cada dispositivo y qué significan.
¿La salida estaba permitida en ese momento?
El servicio también necesita el horario aplicable y cualquier salida autorizada.
Esta información debe incluir su periodo de validez, zona horaria y referencia. Los cambios deben poder identificarse para evitar que una autorización vencida o sustituida siga influyendo en las decisiones solo porque su último valor continúa disponible.
El sistema de gestión de casos debe seguir siendo la fuente autorizada de estos permisos. El workflow de monitoreo debe utilizarlos como contexto, no convertirse silenciosamente en la fuente de verdad.
Cómo utilizar estos datos para interpretar la falta de detección
Una vez definidas las entradas, podemos volver a nuestro escenario de las 9 p. m.
El servicio ya dispone de suficiente contexto para distinguir entre una observación reciente que confirma la presencia, una posible salida o un problema de detección, y una situación en la que el monitoreo simplemente se ha vuelto incierto.
Una detección reciente establece proximidad en ese momento
Si llega una observación reciente procedente de la estación esperada, el servicio puede mostrar esa evidencia junto con su marca de tiempo.
Esto responde a la pregunta sobre la presencia en el momento de la observación. Cualquier alerta independiente del wearable o incidente del equipo debe permanecer abierto para su propia revisión.
Ambos dispositivos transmiten, pero falta la detección local
Supongamos que ambos dispositivos continúan comunicándose, pero desaparece la detección local.
El servicio puede buscar información adicional, como una posición exterior reciente del wearable. Esta combinación puede justificar una investigación por posible salida.
Sin embargo, el correcto funcionamiento de las comunicaciones no demuestra que el enlace de radio local esté funcionando correctamente. Un problema de detección sigue siendo otra explicación posible.
Por eso, el resultado útil no es:
“La persona salió.”
Se parece más a esto:
“La presencia local ya no está confirmada. Los dispositivos están transmitiendo, el wearable proporcionó esta posición reciente, ningún permiso aplicable explica la falta de detección y la situación requiere investigación.”
Este es un punto de partida mucho más útil para un operador.
Cuando el equipo deja de transmitir, la presencia se vuelve incierta
Si alguno de los dispositivos deja de proporcionar información utilizable, el servicio debe clasificar la situación como incertidumbre de monitoreo.
Mantener indefinidamente el estado de presencia anterior ocultaría la interrupción.
El silencio también necesita su propio disparador. Una condición que solo se evalúa cuando llega un paquete puede no ejecutarse nunca después de que la transmisión se detiene. Un timeout verificado en la plataforma o un temporizador externo puede identificar observaciones obsoletas incluso cuando no llega nueva telemetría.
La distinción importante se encuentra entre la ausencia de evidencia y la evidencia de una ausencia. El servicio de monitoreo debe preservar esta diferencia en lugar de convertir una situación incierta en una alerta definitiva.
Cómo implementar la lógica de monitoreo con Navixy
Estas diferencias se traducen en varios requisitos de procesamiento. El siguiente paso consiste en establecer qué partes puede gestionar Navixy con los datos disponibles de los dispositivos y cuáles necesitan configuración o una integración externa.
Primero hay que confirmar qué eventos llegan a Navixy
MT200X está integrado con Navixy y cuenta con capacidades y categorías de reglas relacionadas con la batería, la conectividad, el SOS y el monitoreo del brazalete.
Esta integración no confirma la compatibilidad con todos los eventos de S921. Su mapeo exacto todavía debe verificarse, por lo que el workflow debe considerarse un diseño de referencia que requiere validación antes del despliegue.
Primero deben confirmar:
- qué dispositivo origina cada evento;
- cómo lo decodifica Navixy;
- dónde está disponible el atributo resultante;
- si las marcas de tiempo y los cambios de estado se comportan como se espera.
Los eventos de prueba controlados pueden inspeccionarse con Data Stream Analyzer. Es necesario comprobar los valores ausentes y determinar si una alarma representa una transición o un estado que permanece activo.
Este paso de validación es importante porque la lógica operativa solo será tan confiable como las definiciones de eventos subyacentes.
Evaluar las observaciones con IoT Logic
IoT Logic proporciona atributos calculados, procesamiento condicional y acciones externas.
Una vez verificadas las entradas necesarias, el desarrollador puede utilizar estas capacidades para evaluar las clasificaciones descritas anteriormente. Las observaciones originales deben permanecer disponibles junto con la clasificación derivada, de modo que el operador pueda revisar la evidencia que la respalda.
Si la estación y el wearable reportan como objetos separados, también es necesario correlacionar correctamente su información. Incluir ambos en un mismo flujo no demuestra por sí solo que sus estados más recientes puedan relacionarse correctamente.
Cuando la correlación o el comportamiento temporal necesarios no estén disponibles, puede ser necesario utilizar un servicio externo.
Incorporar permisos aprobados al flujo mediante HTTP Push
El enriquecimiento mediante HTTP Push permite que un sistema externo asocie atributos con un tracker existente para procesarlos junto con la telemetría.
Un sistema de gestión de casos puede utilizar este mecanismo para proporcionar un permiso vigente y su intervalo de validez. La integración debe gestionar la correspondencia de identidades, las actualizaciones de las autorizaciones y la reevaluación en los límites del horario, incluso cuando no llega ningún paquete nuevo del dispositivo.
HTTP Push aporta contexto a la telemetría existente. Si S921 requiere un decodificador externo, esta necesidad debe evaluarse por separado. El enriquecimiento no implementa la compatibilidad con el protocolo del dispositivo.
Enviar la excepción y su evidencia a un sistema de incidentes
Una vez clasificada la excepción, un webhook de IoT Logic puede enviar una solicitud HTTP POST a una aplicación externa.
Un payload útil para la excepción puede incluir:
- la referencia del caso;
- los identificadores de los equipos;
- la clasificación;
- las horas de las observaciones relevantes;
- la referencia de la autorización aplicable.
La aplicación receptora debe crear o actualizar el incidente y asignar la responsabilidad correspondiente.
Los reintentos, duplicados y acuses de recibo deben probarse de forma explícita. El envío de un webhook no demuestra que el incidente haya sido aceptado ni que un operador haya respondido.
¿Quién debe actuar ante la excepción?
El valor del workflow se vuelve más claro cuando seguimos nuestro escenario de las 9 p. m. más allá del procesamiento técnico.
Las distintas clasificaciones pueden dirigir la investigación a equipos diferentes.
Qué necesita investigar el equipo de supervisión
Supongamos que los dispositivos están transmitiendo, el wearable proporciona una posición exterior reciente y ningún permiso aplicable explica la falta de detección en el hogar.
En lugar de reconstruir manualmente los registros de dispositivos y autorizaciones, el operador recibe la evidencia relevante en conjunto, con las marcas de tiempo y cualquier tolerancia configurada.
El workflow no ha decidido que se produjo una infracción. Ha enfocado la investigación al mostrar qué se sabe, qué información falta y por qué la situación puede requerir atención.
Qué necesita soporte cuando el monitoreo se vuelve incierto
Supongamos ahora que la estación dejó de transmitir antes de la comprobación de presencia prevista.
Soporte necesita un conjunto de información diferente: la hora de la última comunicación, los eventos de alimentación relevantes, el estado del wearable vinculado y los detalles de la instalación.
El equipo de supervisión también debe saber que la cobertura del monitoreo es incierta.
Un evento de pérdida de alimentación seguido de silencio constituye una pista de diagnóstico útil, pero no demuestra que la batería de respaldo se haya agotado. El registro del incidente debe seguir distinguiendo entre las condiciones observadas y las causas sospechadas.
La transmisión se ha restablecido. ¿Puede cerrarse el incidente?
La reanudación de la comunicación es un primer hito de recuperación.
La confirmación de observaciones utilizables procedentes de la asociación correcta es otro.
Un incidente relacionado con una perturbación o posible manipulación puede seguir necesitando revisión después de que ambos dispositivos reanuden la transmisión.
Por eso, deben definirse condiciones de cierre para cada tipo de incidente y conservarse la cronología de recuperación. De este modo, los equipos de supervisión y soporte comparten un registro de qué volvió a la normalidad y qué sigue sin resolverse.
¿Cómo saber si el workflow realmente ayudó?
Un workflow de monitoreo solo tiene valor si mejora la operación para la que fue creado.
Esto implica medir algo más que el volumen de alertas.
Registren qué encontraron realmente los investigadores después de una excepción. Las categorías útiles pueden incluir:
- salida autorizada;
- problema confirmado del equipo;
- dificultad de detección local;
- causa sin resolver.
Combinen estos resultados con los tiempos de acuse de recibo y resolución para identificar qué condiciones generan trabajo de forma recurrente y si el contexto adicional está reduciendo el esfuerzo de investigación.
Algunas métricas operativas útiles son:
- tiempo de investigación;
- minutos de incertidumbre de monitoreo;
- incidentes repetidos del equipo;
- tiempo necesario para restablecer observaciones utilizables.
IoT Query puede respaldar el análisis histórico y la inteligencia de negocio en torno a estas métricas, siempre que estén disponibles los atributos necesarios de los dispositivos y los registros externos de las investigaciones.
Una reducción del número de alertas es ambigua por sí sola. Puede indicar que el workflow está gestionando las excepciones de manera más eficaz o que el sistema no está mostrando eventos relevantes.
La carga de trabajo y la calidad del monitoreo deben evaluarse conjuntamente.
La verdadera medida del éxito no consiste simplemente en generar menos alertas. Consiste en crear una operación de monitoreo en la que las excepciones se investiguen más rápido, las fallas técnicas se distingan de los problemas de supervisión de forma más consistente y los periodos de incertidumbre permanezcan visibles en lugar de prolongarse silenciosamente.
Probar el recorrido desde el evento del dispositivo hasta la resolución del incidente
Antes del despliegue, prueben el recorrido completo desde la condición física hasta el registro del incidente que recibe el operador.
Comiencen con una estación y un wearable reales, la documentación correspondiente a la versión del firmware y una lista escrita de los eventos que deben verificarse.
Prueben:
- la asociación de dispositivos, el origen de los eventos y los atributos decodificados;
- la pérdida de detección, la falla de alimentación, la pérdida de comunicación y el restablecimiento;
- los valores obsoletos, los mensajes retrasados y los duplicados;
- la sustitución y reasignación de los equipos;
- los cambios de horario y las autorizaciones vencidas;
- los timeouts cuando no llega telemetría;
- la entrega, el acuse de recibo, la escalación y el cierre del incidente.
Para el escenario inicial de las 9 p. m., una implementación útil debe proporcionar al operador un registro de la evidencia disponible, sus limitaciones y el horario aplicable.
También debe hacer visibles las interrupciones de monitoreo que siguen sin resolverse y dirigir las fallas técnicas a las personas responsables de solucionarlas.
Ese es el valor práctico de combinar las observaciones de la estación doméstica, la telemetría del wearable y el estado del equipo: no convertir datos inciertos en una falsa certeza, sino proporcionar a las personas adecuadas mejor evidencia para decidir qué hacer a continuación.
Contacten al equipo de Navixy para analizar la compatibilidad del hardware y los requisitos de datos de un workflow de monitoreo de presencia en el hogar.
En esta página
- ¿Qué ocurre cuando se requiere presencia en el hogar, pero la detección se detiene?
- Qué aporta una estación doméstica al monitoreo mediante wearables
- Antes de interpretar una señal, hay que establecer su contexto
- Cómo utilizar estos datos para interpretar la falta de detección
- Cómo implementar la lógica de monitoreo con Navixy
- ¿Quién debe actuar ante la excepción?
- ¿Cómo saber si el workflow realmente ayudó?
- Probar el recorrido desde el evento del dispositivo hasta la resolución del incidente